중국 AI가 오픈소스를 택한 진짜 이유는 ‘GPU 부족’이었다
미국보다 적은 컴퓨트는 중국 AI에 약점이었다. 그런데 그 제약이 연구 효율, 모델 공개, 생태계 확산을 촉진하면서 전혀 다른 경쟁 전략을 만들었다. 이제 질문은 누가 가장 강한 모델을 갖느냐보다, 누가 AI의 기본 인프라를 더 넓게 깔 수 있느냐로 이동하고 있다.
20초 핵심
부족한 GPU가 전략을 바꿨다
Reuters의 중국 AI 산업 취재와 최근 관련 보도를 종합하면, 중국 연구소의 출발점은 단순히 “오픈소스를 장려하자”는 정책 구호가 아니었다. 미국의 수출 규제로 최첨단 Nvidia GPU 접근이 제한됐고, 중국의 AI 스타트업이 동원할 수 있는 자본과 컴퓨트도 미국 프런티어 랩보다 작았다. Huawei 역시 2026년 9월 자사의 AI 컴퓨팅 장비 공급이 중국 내 수요를 따라가지 못하고 있다고 인정했다.
컴퓨트가 부족하면 연구 방식이 달라진다. 수백 개 아이디어를 동시에 던져 보고 실패를 돈으로 흡수하기 어렵다. 실험을 더 선별해야 하고, 같은 GPU에서 더 많은 학습을 뽑아내야 하며, 이미 검증된 연구 결과를 재사용하는 가치가 커진다.
DeepSeek의 역사가 이 구조를 잘 보여준다. DeepSeek-V2는 이전 모델보다 학습비용을 42.5% 줄였다고 공개했고, V3와 R1은 모델 가중치와 기술 자료를 외부에 공개했다. 2026년 V4도 오픈웨이트로 배포됐다. 여기서 중요한 것은 단순한 “무료 모델”이 아니다. 한 조직의 최적화가 공개되면 다른 연구팀이 그 위에서 실험하고, 스타트업은 애플리케이션을 만들며, 생태계 전체의 학습 속도가 빨라진다.
미국과 중국은 다른 상품을 팔고 있다
가장 강한 범용 모델을 API와 클라우드 서비스로 제공하고, 모델 레이어에서 직접 높은 가격과 마진을 회수하는 방식이다.
충분히 강한 모델 가중치를 널리 배포하고, 로컬 배치와 커스터마이징을 허용해 생태계 표준에 가까워지는 방식이다.
물론 이 구분은 절대적이지 않다. 미국에도 Meta 계열의 오픈 모델이 있고, 중국에도 폐쇄형 서비스가 있다. 다만 경쟁의 경제학은 분명히 다르다. 미국 프런티어 랩은 막대한 컴퓨트를 모델 성능과 API 매출로 전환하려 하고, 중국의 오픈웨이트 랩은 더 적은 자원으로 확산 속도와 개발자 채택을 끌어올리는 데 강점을 보여왔다.
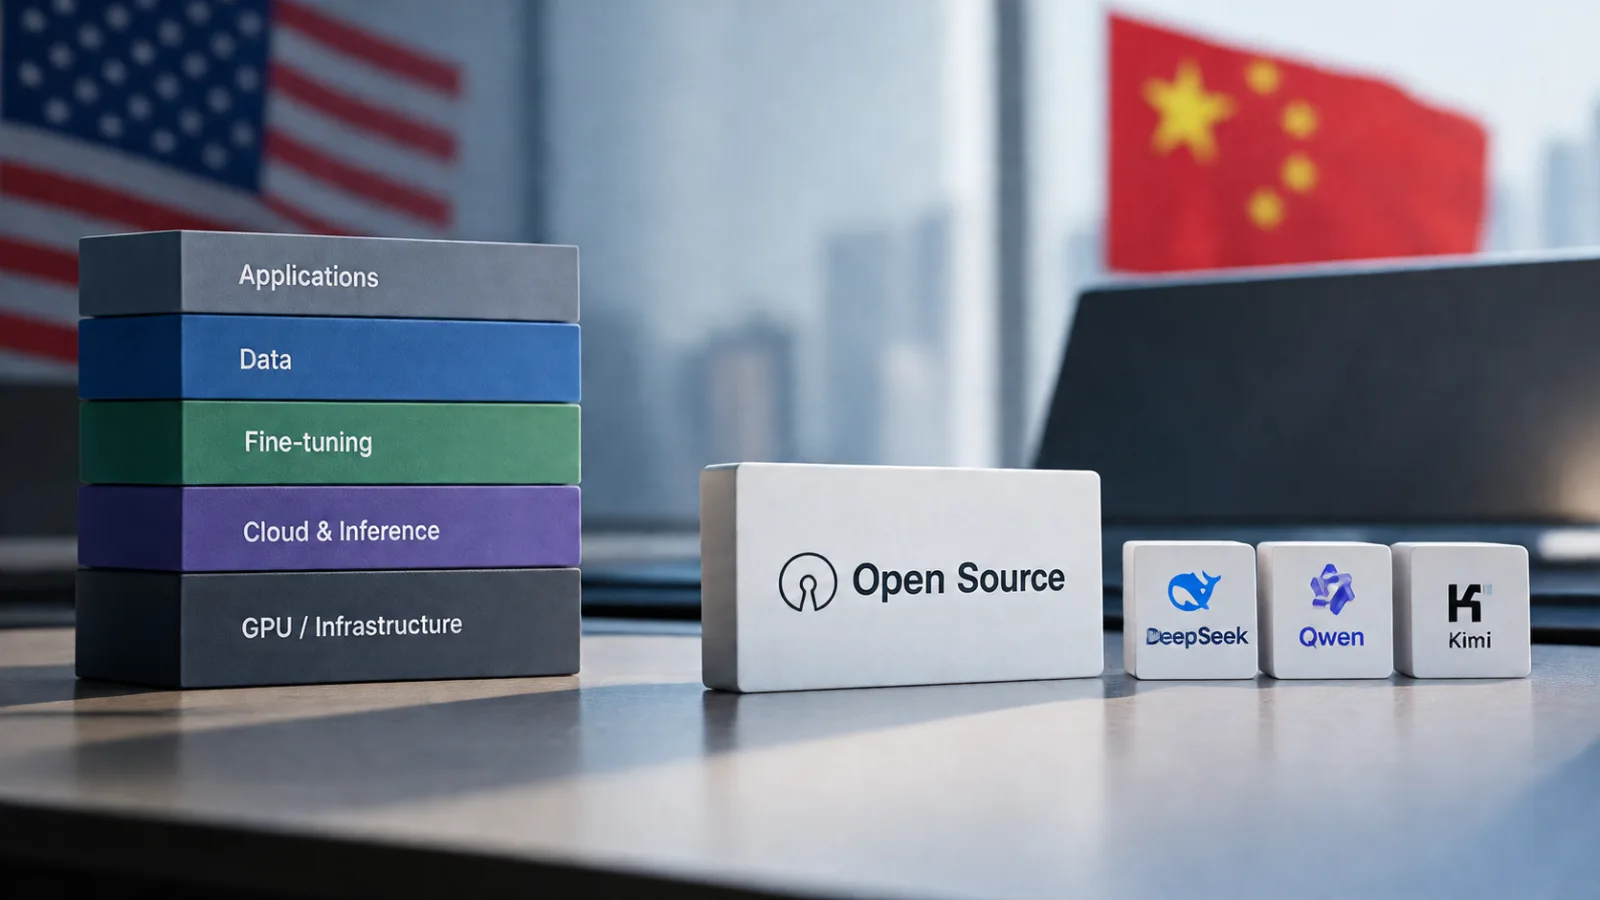
이 차이는 AI 외교에서도 의미가 있다. OpenAI나 Anthropic의 폐쇄형 모델은 기본적으로 외부 API와 서비스 계약을 통해 접근한다. 반면 Qwen, DeepSeek, Kimi 같은 오픈웨이트 모델은 사용자가 가중치를 내려받아 자국 데이터센터나 자체 클라우드에서 운용할 수 있다. 데이터 주권과 비용 통제를 중시하는 국가와 기업에는 매력적인 선택지가 될 수 있다.
그러나 사용량과 매출은 같은 것이 아니다
중국 전략의 가장 큰 약점도 바로 여기 있다. 모델이 널리 퍼질수록 영향력은 커지지만, 가중치를 외부에 배포하면 모든 추론 매출이 원 개발사로 돌아오지는 않는다. Reuters Breakingviews는 중국 AI 기업들이 높은 연구개발비와 낮은 가격 경쟁 때문에 매출과 마진 압박을 받고 있다고 지적했다.
Alibaba가 2026년 8월 차세대 Qwen의 대형 상업 이용자에게 수익 공유를 요구하는 방안을 추진한 것도 이 문제를 보여준다. 오픈웨이트의 확산력을 유지하면서도, 거대한 상업적 사용에서 일부 경제적 가치를 되찾으려는 실험이다.
| AI 가치사슬 | 오픈웨이트 확산 시 변화 | 투자자가 볼 변수 |
|---|---|---|
| 모델 API | 가격 압력 증가 | 프런티어 성능 프리미엄이 유지되는가 |
| 클라우드 · 추론 | 사용량 증가의 직접 수혜 가능 | GPU 가동률, 추론단가, 고객 락인 |
| 애플리케이션 · 에이전트 | 모델 교체 비용 하락 | 업무 데이터, 워크플로 통합, 고객 전환비용 |
| 데이터 · 후학습 | 차별화 지점이 모델 밖으로 이동 | 독점 데이터와 검증 가능한 업무 성능 |
| 반도체 · 인프라 | 전체 AI 사용량 확대 가능 | 추론량, 메모리, 네트워킹, 전력 수요 |
이 때문에 중국 오픈 AI의 위협은 반드시 ChatGPT 사용자를 직접 빼앗는 형태로 나타날 필요가 없다. 더 중요한 시나리오는 기업 AI 스택의 아래쪽에서 기본 모델로 스며드는 것이다. Thomson Reuters는 2026년 자체 전문 모델을 만들면서 강한 오픈 모델을 기반으로 사용했고, 총 4,000만달러를 들여 자사 데이터와 전문가 지식으로 후학습했다. 범용 프런티어 모델을 매번 호출하는 대신, 특정 업무에 맞는 지능을 직접 소유하려는 흐름이다.
중국 AI의 오픈웨이트 전략은 기술 철학이라기보다 자원 제약에서 시작된 경제적 적응에 가깝다. GPU가 부족하니 효율이 중요해졌고, 혼자 모든 연구비를 감당하기 어려우니 생태계의 집단 학습이 유리해졌다. 그 전략이 예상보다 잘 작동하면서 이제는 국가 차원의 확산 전략과 결합하고 있다.
다만 “중국 오픈 AI가 결국 미국 폐쇄형 AI를 이긴다”는 결론은 너무 빠르다. 가장 어려운 추론과 에이전트 업무에서는 여전히 프런티어 모델의 성능 프리미엄이 남을 수 있고, 보안, 규제, 데이터 거버넌스 때문에 중국계 모델을 쓰지 않는 기업도 존재한다. 오픈웨이트는 무료가 아니다. 직접 운영하려면 GPU, 엔지니어링, 보안 비용이 든다.
장기적으로 더 중요한 질문은 모델 자체가 얼마나 commoditize될 것인가 다. 만약 충분히 좋은 모델이 흔해지면 경제적 가치는 모델 레이어에서 클라우드, 독점 데이터, 후학습, 애플리케이션, 에이전트와 고객 워크플로로 이동할 가능성이 커진다. Linux가 소비자 PC의 지배자가 아니어도 서버와 인터넷 인프라의 핵심이 된 것처럼, 중국 오픈웨이트 AI의 가장 큰 성공은 소비자 앱 1위가 아니라 보이지 않는 기본 레이어가 되는 것일 수 있다.
- 산업 정책의 영향은 분명히 있다. 다만 최근 취재와 업계 사례를 보면 초기 동력은 컴퓨트와 자본 제약에 대응한 연구 효율화에서도 나왔다. 이후 정부가 확산 전략의 가치를 적극적으로 받아들였다고 보는 편이 더 자연스럽다.
- 그렇지 않다. 가중치 사용료가 낮아도 직접 호스팅하려면 GPU, 운영 인력, 보안, 최적화 비용이 든다. 사용량과 업무 특성에 따라 상용 API가 더 저렴할 수 있다.
- 중국 내 수출 규제는 Nvidia의 직접 판매에 제약이다. 반면 글로벌 시장에서 저렴한 오픈 모델이 AI 사용량을 늘리면 추론 컴퓨트 수요에는 긍정적일 수 있다. 지역 규제와 전체 수요 효과를 분리해 봐야 한다.
- “누가 최고의 모델을 만드나”보다 “모델이 흔해질 때 누가 희소한 자산을 갖고 있나”다. 독점 데이터, 고객 워크플로, 클라우드 유통, GPU와 메모리, 전력, 검증 가능한 에이전트 환경이 다음 가치 포착 지점이 될 수 있다.
체크 포인트
인사이트 타임스 편집부