GPU가 근육이면 네트워크는 신경이다
AI 데이터센터는 GPU를 많이 사는 것만으로 빨라지지 않는다. 수천~수십만 개의 가속기가 데이터를 제때 주고받지 못하면 비싼 GPU가 기다리며 놀게 된다. Arista의 투자 논리는 바로 여기에 있다. AI 경쟁이 칩 성능에서 시스템 효율로 이동할수록 네트워크가 전체 컴퓨팅의 가동률과 경제성을 결정한다.
20초 핵심
AI 클러스터에서 가장 비싼 것은 GPU인데, 가장 아까운 것도 ‘기다리는 GPU’다
AI 데이터센터에서 가장 비싼 자산은 대개 가속기다.
GPU 한 개가 비싸다. 수천 개가 모이면 투자금은 급격히 커진다.
그런데 이 비싼 GPU가 항상 계산만 하고 있는 것은 아니다.
다른 GPU가 만든 데이터를 기다린다. 메모리를 기다린다. 네트워크 전송이 끝나기를 기다린다. 통신 충돌이 해소되기를 기다린다.
이 시간이 길어지면 GPU utilization이 떨어진다.
100억달러어치 GPU를 샀는데 네트워크 때문에 실제 활용률이 낮다면, 네트워크 병목은 사실상 GPU를 덜 산 것과 같은 결과를 만든다.
그래서 AI 클러스터가 커질수록 네트워크는 주변 부품이 아니다. 컴퓨팅 자산의 실제 수익률을 결정하는 설비가 된다.
왜 AI는 일반 Cloud보다 네트워크에 더 민감한가
전통적인 Cloud workload는 비교적 독립적인 서버가 많은 구조였다.
AI 학습은 다르다. 거대한 모델 하나를 수천 개 GPU가 나눠 계산한다.
한 GPU가 계산한 결과를 다른 GPU가 받아야 다음 연산이 진행된다. Gradient를 합치고 Parameter를 동기화하며 Tensor를 이동한다.
Inference도 모델이 여러 가속기에 분산되면 GPU 사이 통신이 필요하다.
즉 하나의 AI job이 수천 개 칩을 사실상 하나의 거대한 컴퓨터처럼 움직이게 만든다.
그래서 AI 클러스터에서는 bandwidth뿐 아니라 latency, congestion, packet loss, load balancing이 전체 job completion time에 직접 영향을 준다.
네트워크가 느리면 칩이 빨라도 시스템은 느리다.
Scale-up과 Scale-out을 구분해야 Arista가 보인다
Scale-up은 매우 가까운 가속기들을 하나의 거대한 시스템처럼 묶는 영역이다. 한 서버 안, 한 랙 안, 또는 랙에 매우 가까운 범위다. 낮은 latency와 매우 높은 bandwidth가 필요하다.
NVIDIA는 NVLink와 NVSwitch에서 강한 지위를 갖고 있다.
Scale-out은 더 넓다. 여러 랙과 클러스터, 수천·수만·수십만 개 가속기를 연결한다.
여기서는 Ethernet 생태계가 강하다. Arista가 오랫동안 강점을 쌓아온 곳도 바로 이 대규모 Ethernet fabric이다.
과거에는 scale-up과 scale-out의 경계가 비교적 뚜렷했다. 하지만 AI rack-scale architecture가 커지면서 경계가 조금씩 겹치기 시작하고 있다.
Arista가 1.6T 플랫폼을 scale-out뿐 아니라 scale-up까지 확장하는 이유다.
Ethernet이 AI에서 다시 강해지는 이유
AI 네트워크에서는 오랫동안 InfiniBand와 Ethernet의 경쟁이 강조됐다.
InfiniBand는 HPC와 초기 대규모 AI 학습에서 낮은 latency와 고성능으로 강했다.
Ethernet의 장점은 개방형 표준, 거대한 공급 생태계, 다양한 스위치 실리콘, Cloud 운영자에게 익숙한 운영방식, 여러 공급업체를 선택할 수 있다는 점이다.
AI 클러스터가 수십만 XPU 규모까지 커지면 성능만큼 운영성과 공급망도 중요해진다.
한 공급업체의 독점 구조에 모든 네트워크를 의존하는 것보다 Ethernet 기반에서 여러 가속기와 스위치, NIC를 조합하는 방식이 hyperscaler에게 매력적일 수 있다.
Arista의 장기 투자 논리는 Ethernet이 AI workload에 충분한 성능을 제공하면서 개방성과 운영 유연성까지 유지할 수 있다는 데 있다.
1.6T는 단순히 800G의 두 배가 아니다
1.6T는 포트 하나가 초당 1.6테라비트 데이터를 처리한다는 뜻이다. 800G의 두 배다.
하지만 AI 데이터센터에서 의미는 단순한 속도 두 배가 아니다.
같은 수의 포트로 더 많은 GPU를 연결할 수 있다. 같은 rack space에서 더 큰 fabric을 만들 수 있다. 필요한 스위치 계층을 줄일 수 있다. 네트워크 hop 수가 줄어 latency와 전력소모를 낮출 수 있다.
Arista의 7060XE7 계열은 시스템당 102.4Tbps 대역폭을 제공한다. 64개의 1.6T 포트 또는 128개의 800G 연결 같은 구성이 가능하다.
이 수준에서는 스위치 한 대가 단순 연결장치가 아니라 rack-scale AI architecture의 일부가 된다.
네트워크의 새로운 경쟁단위는 ‘Gbps’가 아니라 ‘GPU당 유효 연산’이다
네트워크 업체는 전통적으로 포트 수와 속도를 강조했다.
100G, 400G, 800G, 1.6T.
하지만 AI 시대에는 이 숫자만으로 부족하다.
투자자가 봐야 할 최종 결과는 GPU가 얼마나 덜 기다리는가다.
예를 들어 네트워크 개선으로 GPU utilization이 60%에서 70%로 올라간다고 가정하면 같은 GPU 수에서 usable compute는 약 17% 늘어난다.
실제 효과는 workload와 topology에 따라 다르지만 경제적 원리는 같다.
네트워크는 서버 비용의 작은 일부일 수 있다. 그러나 네트워크가 전체 GPU 자산의 utilization을 몇 퍼센트만 개선해도 ROI 효과는 훨씬 커질 수 있다.
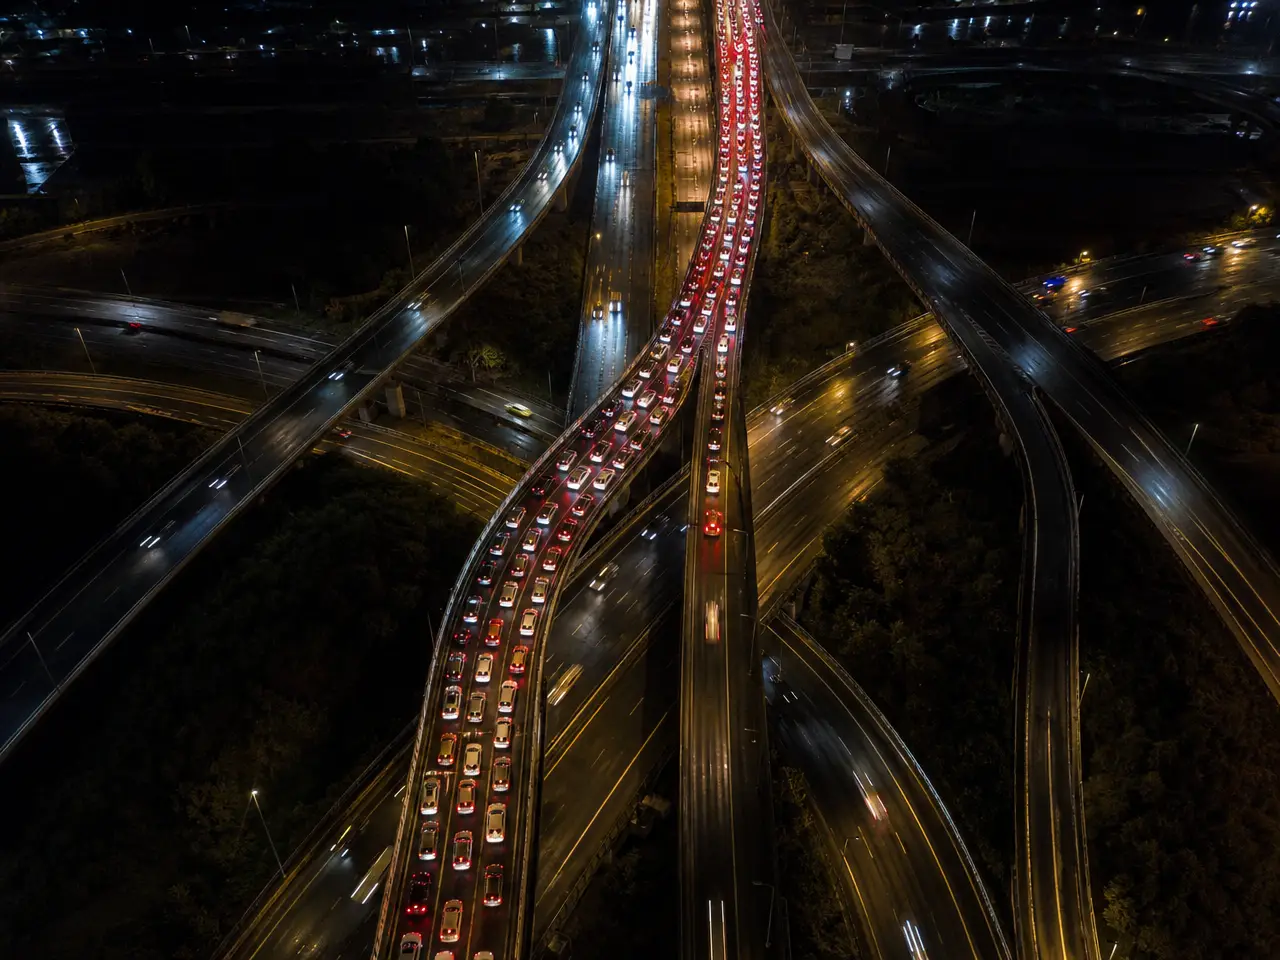
Congestion은 AI 데이터센터의 ‘교통체증’이다
수천 개 GPU가 동시에 데이터를 보내면 트래픽은 고르게 흐르지 않는다.
특정 순간 특정 경로에 데이터가 몰리고, 스위치 buffer가 차고, packet이 지연되며, 재전송이 발생할 수 있다.
AI 네트워크에서 congestion management와 load balancing이 중요한 이유다.
Arista는 7060XE7와 EOS에 dynamic load balancing, cluster load balancing 등 AI fabric용 기능을 넣고 있다.
핵심은 단순히 빠른 길을 만드는 것이 아니다. 트래픽을 여러 경로에 효율적으로 분산해 특정 구간이 병목이 되지 않도록 하는 것이다.
AI 시스템에서는 가장 느린 구간이 전체 job의 속도를 결정한다.
Arista의 진짜 해자는 하드웨어보다 EOS에 있다
Arista를 스위치 박스 회사로만 보면 NVIDIA를 GPU 칩 회사로만 보는 것과 비슷한 오류를 범할 수 있다.
Arista의 핵심 자산 가운데 하나는 EOS, Extensible Operating System이다.
대형 Cloud 데이터센터의 네트워크는 스위치를 설치하고 끝나는 구조가 아니다.
수천, 수만 개 장비의 상태를 관리하고, 트래픽을 모니터링하고, 장애를 찾고, 업데이트하고, 자동화하며, 클러스터 전체에서 일관된 정책을 유지해야 한다.
AI 데이터센터는 규모와 트래픽 패턴이 더 복잡하다.
따라서 networking software의 중요성은 더 커진다.
Arista의 EOS가 hyperscaler 환경에 깊게 들어가면 스위치 하드웨어를 바꾸는 문제 역시 단순하지 않게 된다.
Arista의 해자는 빠른 port speed와 함께 운영 소프트웨어와 고객 workflow에서 나온다.
Q2 2026 숫자가 보여주는 것: 성장률뿐 아니라 마진도 높다
Arista의 Q2 2026 매출은 30억3,600만달러였다.
전년 동기 22억500만달러보다 37.7% 증가했고 처음으로 분기 매출 30억달러를 넘어섰다.
GAAP operating margin은 45.4%, non-GAAP operating margin은 49.9%였다.
Non-GAAP EPS는 전년 대비 약 40% 증가했다.
이 숫자가 중요한 이유는 Arista가 고성장하면서도 매우 높은 마진을 유지하고 있다는 점이다.
대형 Cloud 고객과 데이터센터에서 소프트웨어, 운영성, 고성능 Ethernet에 대한 높은 가치를 인정받고 있다는 의미다.
다만 높은 마진은 동시에 높은 기대가 이미 반영됐을 가능성도 뜻한다.
장기 투자자는 성장률뿐 아니라 이 마진이 경쟁과 고객 협상 속에서도 얼마나 유지되는지를 봐야 한다.
Arista의 가장 큰 강점이 동시에 가장 큰 위험이다: Cloud titan
Arista는 세계 최대 Cloud 기업들과 깊은 관계를 갖고 있다.
이것이 AI 시대의 가장 큰 강점이다.
Hyperscaler는 가장 먼저 400G에서 800G로 가고, 다시 1.6T로 이동한다. 가장 큰 AI 클러스터를 만든다.
Arista는 이 고객들과 함께 신제품을 검증하고 대규모로 배치할 수 있다.
하지만 고객집중도는 위험이기도 하다.
대형 Cloud 고객은 구매력이 강하고, 직접 네트워크 설계를 하며, 화이트박스와 자체 소프트웨어를 선택할 수도 있다.
특정 프로젝트 하나의 일정 변경이 공급업체 실적에 큰 영향을 줄 수 있다.
따라서 Arista의 AI 성장에서 가장 중요한 위험은 Ethernet이 사라지는 것이 아니라 hyperscaler가 네트워크 가치의 더 많은 부분을 직접 가져가는 것이다.
NVIDIA는 경쟁자인가, 시장을 키워주는 존재인가
Arista와 NVIDIA의 관계를 단순 경쟁으로 보는 것도 부정확하다.
NVIDIA는 NVLink와 InfiniBand, Spectrum-X를 갖고 있다. 특히 scale-up과 AI networking 전반에서 강한 경쟁자다.
동시에 NVIDIA GPU가 많이 팔릴수록 전체 scale-out 네트워크 시장도 커진다.
즉 NVIDIA는 Arista에게 위협이면서 시장을 만들어주는 존재다.
장기적으로 중요한 것은 AI 클러스터의 어느 구간을 proprietary fabric이 차지하고, 어느 구간을 open Ethernet이 차지하는가다.
Arista가 1.6T Etherlink를 scale-up 영역까지 확장하려는 것은 이 경계를 조금씩 안쪽으로 밀어보려는 시도다.
전력과 냉각도 네트워크 설계의 일부가 된다
AI 네트워크의 속도가 올라갈수록 전력문제도 커진다.
고속 SerDes, optical transceiver, switch ASIC은 모두 전력을 먹고 열을 만든다.
수천 개 optical module이 모이면 네트워크 자체도 상당한 전력소비원이 된다.
그래서 1.6T 전환에서는 throughput 외에 watts per bit가 중요하다.
Arista는 7060XE7에서 air-cooled와 liquid-cooled 구성을 모두 제공한다.
또 LPO, Linear Pluggable Optics를 활용해 회사 설명 기준 관련 광학 전력소모를 크게 낮추는 방향을 제시하고 있다.
AI 시스템 최적화의 범위가 GPU에서 네트워크까지 확대되고 있다는 뜻이다.
AI 클러스터가 커질수록 ‘시스템 회사’가 유리해진다
과거 데이터센터에서는 서버, 네트워크, 스토리지를 비교적 독립적인 부품으로 생각할 수 있었다.
AI에서는 경계가 흐려진다.
GPU topology, network topology, 메모리, 전력, 냉각, software scheduling이 서로 영향을 준다.
Arista도 7060XE7을 단순 스위치가 아니라 rack-scale system의 일부로 설명한다.
AI 산업의 경쟁단위가 부품에서 시스템으로 올라가는 것이다.
NVIDIA가 GPU에서 rack-scale AI Factory로 올라가듯 Arista도 switch vendor에서 AI fabric system vendor로 올라가려 한다.
누가 이 전환에 성공하는지가 장기 마진을 결정할 수 있다.
Arista 투자에서 가장 위험한 착시는 ‘GPU 출하량만 보면 된다’는 생각이다
Arista는 AI 인프라 수혜주다.
하지만 NVIDIA GPU 출하량과 Arista 매출이 일대일로 움직이는 것은 아니다.
중요한 것은 클러스터의 topology다.
GPU가 어디에 배치되는가. 한 클러스터가 얼마나 커지는가. Ethernet port speed가 얼마나 빨리 올라가는가. 네트워크를 몇 계층으로 구성하는가. Hyperscaler가 자체 network stack을 얼마나 쓰는가. 800G에서 1.6T 전환이 언제 본격화되는가.
이 변수가 Arista의 매출과 마진을 결정한다.
따라서 AI GPU CAPEX가 계속 증가한다는 사실만으로 Arista 투자 논리가 자동으로 완성되지는 않는다.
Arista가 그 네트워크 가치 가운데 얼마를 가져가는지를 따로 봐야 한다.
Arista의 투자 논리를 “AI 때문에 데이터센터 스위치가 많이 팔린다”로 축약하면 핵심을 놓친다.
진짜 Signal은 AI 클러스터가 커질수록 네트워크가 GPU utilization과 job completion time을 결정하는 시스템 변수로 올라간다는 점이다.
네트워크에 쓰는 1달러가 수십 달러짜리 GPU 자산을 더 오래 계산하게 만든다면 네트워크의 경제적 가치는 장비 원가보다 훨씬 커진다.
확신 수준: 높음.
다만 Arista의 장기 상승 논리는 Ethernet이 scale-out에서 강한 지위를 유지하고 일부 scale-up까지 확장할 수 있다는 가정에 달려 있다.
NVIDIA의 proprietary fabric이나 hyperscaler의 자체 네트워크 설계가 더 높은 cost-to-outcome을 제공하면 기대보다 TAM이 작아질 수 있다.
- Scale-up은 가까운 GPU들을 매우 낮은 latency로 하나의 큰 시스템처럼 묶는 영역이다.
- Scale-out은 여러 랙과 클러스터를 더 넓게 연결하는 영역이다.
- NVLink가 모든 데이터센터 네트워크를 대체하는 것은 아니다.
- 대규모 클러스터의 scale-out에는 Ethernet 같은 광범위한 network fabric이 필요하다.
- 아니다.
- 포트 가격, 장비 구성, topology, 교체주기, 고객 협상에 따라 경제성은 달라진다.
- 중요한 것은 실제 deployment와 제품 믹스다.
- 고성능 Ethernet 하드웨어뿐 아니라 EOS와 대형 Cloud 고객 환경에서 쌓인 운영 소프트웨어, 자동화, 안정성 경험이다.
- NVIDIA proprietary networking 확대.
- hyperscaler 자체 설계.
- 고객집중도.
- Ethernet 장비 경쟁.
- AI CAPEX 둔화다.
체크 포인트
출처
인사이트 타임스 편집부
AI 사용 고지
이 기사는 사람 편집자가 기획하고, 사람과 AI가 같이 초안을 쓰고 수정하고, 최종 사람 편집자가 사실과 표현을 확인해 발행했습니다. 수치와 인용은 본문에 적힌 자료에서 가져왔습니다.