Nvidia의 새 GPU가 3.7배 빨라졌다는 것보다 중요한 숫자는 99%다
GPU 72개를 288개로 늘렸는데 처리량도 거의 4배가 됐다. 이 숫자는 AI 데이터센터의 경쟁이 더 이상 “누가 가장 빠른 칩을 만드느냐”만의 싸움이 아니라는 사실을 보여준다.
20초 핵심
GPU를 4배 사도 AI가 4배 빨라지지는 않는다
AI 서버를 레고처럼 생각하면 쉽다. GPU 한 개가 일을 잘한다고 해서 수백 개를 연결했을 때도 모두가 쉬지 않고 일하는 것은 아니다. 어떤 GPU는 다른 GPU가 계산을 끝내기를 기다리고, 어떤 GPU는 데이터를 받느라 멈추며, 네트워크가 막히면 비싼 연산장치 전체가 줄을 선다.
그래서 대규모 AI 시스템에는 scaling efficiency라는 숫자가 중요하다. 장비를 늘린 만큼 실제 처리량이 얼마나 따라오는지 보는 지표다.
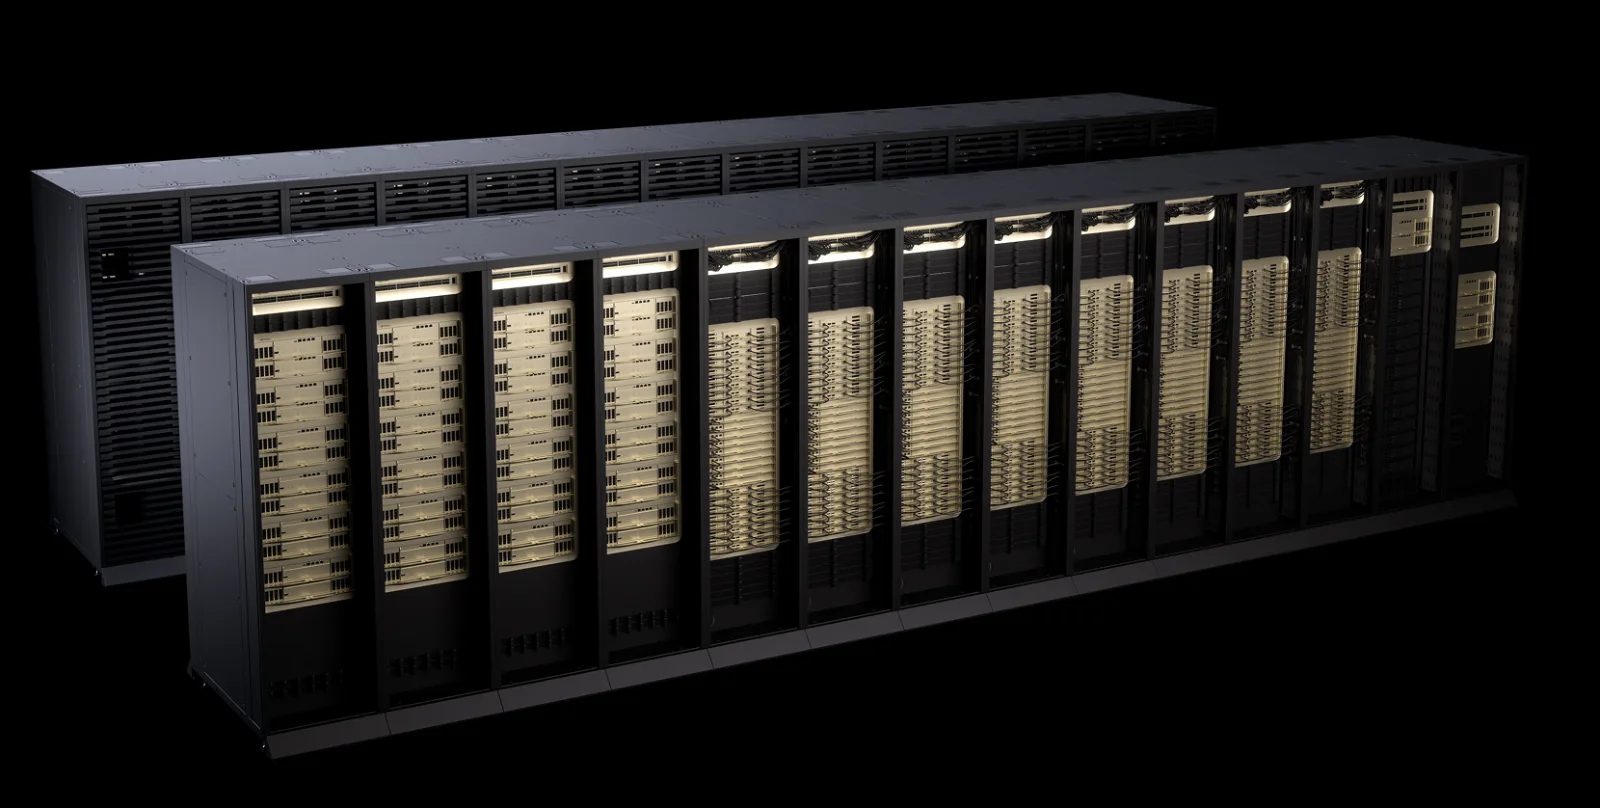
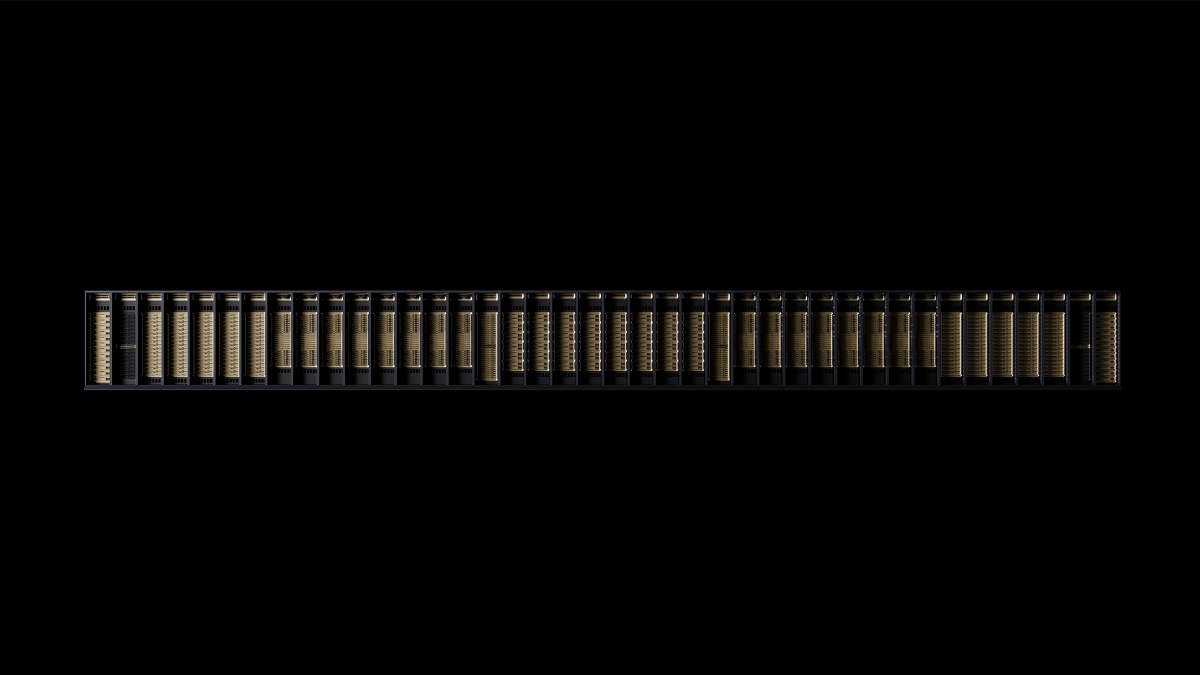
Nvidia가 공개한 MLPerf Inference v6.1 결과에서 GB300 NVL72는 DeepSeek-R1 오프라인 시나리오 기준 한 랙 72 GPU에서 네 랙 288 GPU까지 늘어났을 때 99% scaling efficiency를 기록했다. 즉 랙을 네 배 설치하면서도 성능 손실을 거의 만들지 않았다는 것이다.
이것이 중요한 이유는 단순하다. AI 데이터센터에서 가장 비싼 자산 가운데 하나가 GPU인데, GPU가 서로 기다리는 시간이 늘어날수록 같은 양의 AI 서비스를 제공하기 위해 더 많은 GPU와 더 많은 자본이 필요해진다.
AI 공장의 진짜 생산품은 GPU가 아니라 토큰이다
자동차 공장의 생산성을 자동차 대수로 보듯, 생성형 AI 데이터센터는 결국 일정 시간에 얼마나 많은 추론 결과를 만들어내는지가 중요하다. 대형언어모델에서는 이를 토큰 처리량으로 단순화해 볼 수 있다.
같은 GPU 수로 더 많은 토큰을 만들수록 장비 투자 효율이 높아진다.
전력이 AI 데이터센터의 핵심 제약이 될수록 성능보다 중요한 지표가 될 수 있다.
칩, 네트워크, 전력, 냉각, 소프트웨어를 모두 합친 경제성의 최종 결과에 가깝다.
이 관점에서 보면 “Rubin이 Blackwell보다 몇 배 빠른가”라는 질문은 절반짜리 질문이다. 더 중요한 것은 같은 1달러의 AI CAPEX가 얼마나 많은 유료 추론을 만들어낼 수 있는가다.
3.7배보다 1.6배가 더 무서울 수 있는 이유
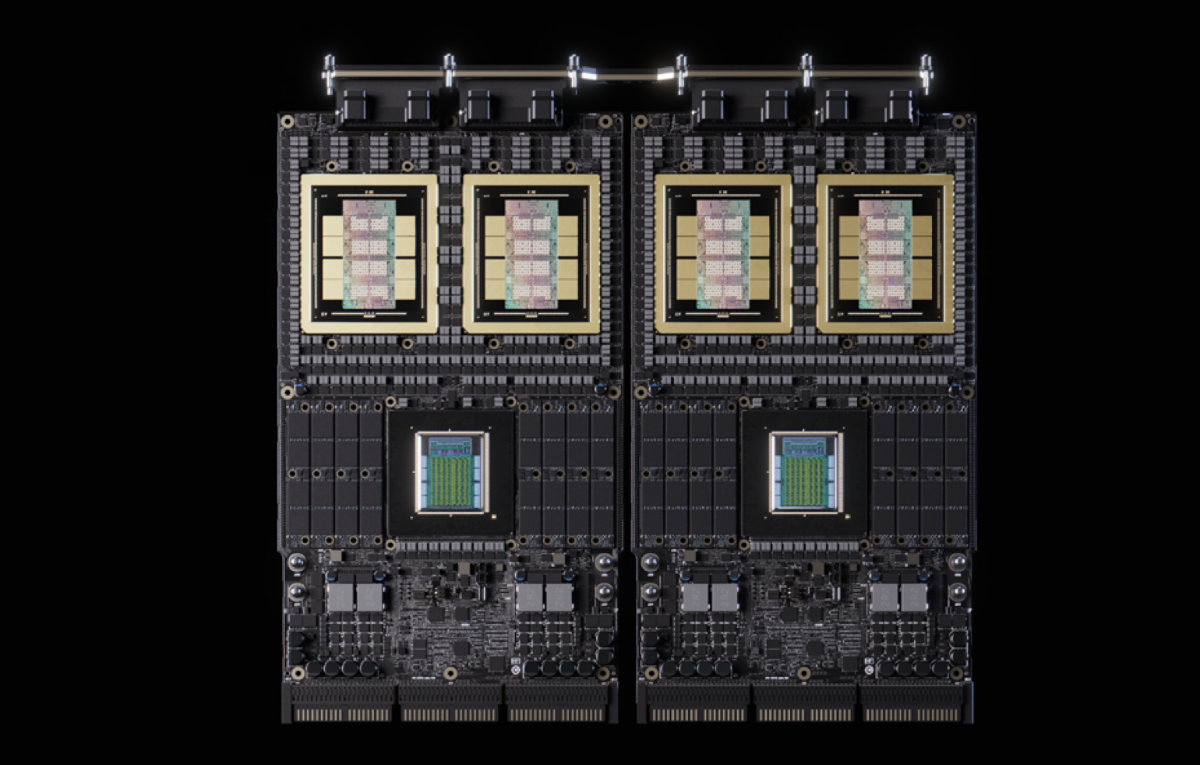
Vera Rubin의 최대 3.7배 성능 향상은 눈에 잘 띈다. 하지만 데이터센터 사업자에게는 같은 GB300 하드웨어가 소프트웨어 업데이트만으로 더 빨라진다는 사실도 중요하다.
Nvidia에 따르면 MLPerf v6.1의 GB300 NVL72는 Qwen3-VL에서 v6.0보다 최대 1.6배 높은 성능을 냈다. 개선에는 KV cache 정밀도 축소, kernel fusion, 커널 개선, prefill과 decode를 분리하는 serving 방식 등이 사용됐다.
쉽게 말하면 이렇다.
공장을 새로 짓지 않았고, 기계도 바꾸지 않았는데 공정 소프트웨어를 개선해 하루 생산량이 늘어난 셈이다.
이를 문자 그대로 “공짜 CAPEX”라고 부를 수는 없다. 소프트웨어 개발비도 들고 실제 서비스 환경에서는 성능 향상이 다르게 나타날 수 있다. 다만 이미 설치된 GPU의 경제적 수명을 늘리고 투자수익률을 높이는 효과가 있다는 점은 분명하다.
이 지점에서 Nvidia는 전통적인 반도체 회사와 조금 다른 경제성을 갖는다. 한 번 판매한 GPU가 CUDA, TensorRT-LLM, Dynamo, vLLM 연동, 네트워크 최적화 같은 소프트웨어 개선을 통해 시간이 지나도 더 많은 일을 할 수 있기 때문이다.
왜 ‘칩 회사’보다 ‘AI 공장 회사’에 가까워지고 있나
대규모 추론에서는 가장 빠른 GPU 하나만으로 승부가 끝나지 않는다. 수백 개 GPU를 묶는 네트워크, 메모리 이동, 랙 설계, 컴파일러, 추론 엔진, 모델별 최적화, 작업 분배가 동시에 맞아야 한다.
| 경쟁 요소 | 무엇을 해결해야 하나 | 경제성에 미치는 영향 |
|---|---|---|
| GPU | 행렬 연산과 추론 자체를 빠르게 처리 | 기본 생산능력 |
| HBM · 메모리 | 모델과 KV cache를 빠르게 공급 | GPU 대기시간 감소 |
| NVLink · 네트워크 | GPU와 랙 사이 데이터를 빠르게 이동 | 대규모 확장 효율 |
| Inference software | 요청 묶기, 모델 분할, prefill · decode 배치 최적화 | 같은 장비의 처리량 증가 |
| Rack · power · cooling | 고밀도 시스템을 실제 데이터센터에서 안정적으로 운영 | 전력당, 면적당 산출량 |
결국 경쟁단위는 “GPU 한 개”에서 “AI factory 전체”로 커진다. Nvidia가 강한 이유를 실리콘 성능 하나로만 설명하면 이 부분을 놓치게 된다.
그렇다고 99%가 Nvidia의 독점적 마법은 아니다
여기서는 과장을 경계해야 한다. 이번 99%는 특정 MLPerf DeepSeek-R1 오프라인 테스트에서 나온 결과다. 실제 클라우드 서비스는 사용자의 요청 크기, 지연시간 요구, 모델 종류, 네트워크 혼잡, 전력 제약이 모두 다르다. 벤치마크 99%가 곧바로 모든 데이터센터의 99% 효율을 뜻하지 않는다.
또한 MLPerf v6.1 전체를 보면 다른 업체들도 대규모 확장 기술을 빠르게 개선하고 있다. 이번 라운드에는 512개 가속기를 사용한 시스템까지 등장했고, MangoBoost는 서로 다른 대륙의 네 지역을 하나의 endpoint처럼 묶은 시스템에서 97% scaling efficiency를 보고했다. AI 추론이 점점 scale-out 산업으로 이동하고 있다는 신호는 Nvidia만의 이야기가 아니다.
따라서 99%가 말해주는 진짜 메시지는 “Nvidia만 가능하다”가 아니라, 앞으로 AI 인프라의 승부가 개별 칩 성능보다 시스템 전체의 낭비를 얼마나 줄이느냐로 이동한다는 것이다.
이번 결과에서 가장 흥미로운 숫자를 하나만 고른다면 3.7배보다 99%에 가깝다.
3.7배는 세대 교체의 속도를 보여준다. 반면 99%는 그 비싼 칩을 수백 개 설치했을 때 돈이 실제 산출량으로 얼마나 잘 전환되는가 를 보여준다. 그리고 1.6배의 소프트웨어 개선은 이미 팔린 하드웨어의 생산성까지 계속 높일 수 있음을 보여준다.
이 세 숫자를 함께 보면 Nvidia의 해자를 조금 다르게 볼 수 있다. GPU 성능 자체도 중요하지만, 장기적으로는 GPU, HBM, NVLink, 랙, 컴파일러, 추론 소프트웨어를 하나의 생산 시스템으로 묶어 token per dollar 을 계속 낮출 수 있는 능력이 더 중요해질 가능성이 있다.
투자자에게도 질문을 바꿀 필요가 있다. “Rubin이 얼마나 빠른가”보다 “하이퍼스케일러가 같은 전력과 같은 자본으로 얼마나 많은 추론을 팔 수 있는가”, 그리고 “그 경제성 개선에서 Nvidia가 얼마나 큰 몫을 가져가는가”를 보는 편이 더 유용하다.
- 아니다. utilization은 GPU가 실제 시간 중 얼마나 바쁘게 일했는지를 보는 개념이다. scaling efficiency는 GPU 수를 늘렸을 때 처리량이 이상적인 비율에 얼마나 가깝게 증가했는지를 본다.
- 아니다. 이번 수치는 Vera Rubin NVL72의 MLPerf preview submission에서 Qwen3-VL 특정 시나리오를 GB300 NVL72와 비교한 최대치다. 모델, 지연시간 조건, batch 크기, serving 방식에 따라 결과는 달라질 수 있다.
- 같은 수요라면 필요한 GPU 수를 줄이거나 기존 GPU로 더 많은 요청을 처리할 수 있다. 그러나 AI 사용량 자체가 더 빠르게 늘면 총 GPU 수요는 오히려 증가할 수 있다. 효율 향상과 총수요 증가는 동시에 일어날 수 있다.
- 그 정도의 결론은 이르다. 실제 고객 워크로드, 전력비, 시스템 가격, 경쟁 플랫폼의 성능, 소프트웨어 호환성까지 봐야 한다. MLPerf는 중요한 비교 자료지만 전체 경제성을 대신하지는 않는다.
체크 포인트
인사이트 타임스 편집부