엔비디아와 팔란티어가 공급망에 AI를 넣었다 - 진짜 변화는 ‘판단’을 학습하기 시작했다는 것
베라 루빈 랙 하나에는 130만 개의 부품이 들어간다. 엔비디아와 팔란티어가 만든 새 공급망 AI의 핵심은 이 복잡성을 자동화하는 데만 있지 않다. 더 중요한 변화는 사람 머릿속에 있던 공급망 판단 기준을 모델이 배우고, 다시 기업의 운영 자산으로 축적하기 시작했다는 데 있다.
20초 핵심
130만 개 부품보다 더 어려운 것은 ‘사람의 판단’이었다
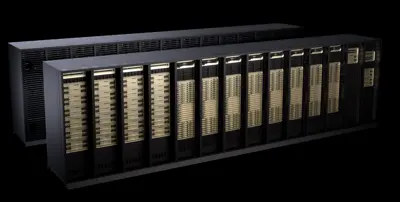
엔비디아의 차세대 Vera Rubin 랙에는 약 130만 개의 개별 부품이 들어간다. GPU와 CPU, HBM 메모리만 맞추면 끝나는 구조가 아니다. 네트워킹, 전력, 냉각, 기계 부품까지 제때 모여야 하나의 랙이 완성된다. 엔비디아 설명에 따르면 Vera Rubin 공급망은 Grace Blackwell보다 두 배 크다.
이런 환경에서 공급망의 문제는 “재고가 몇 개인가”보다 “부족한 부품을 어느 제조 사이트에 먼저 보내야 전체 생산이 가장 빨라지는가”에 가깝다. 엔비디아는 이 자재 배분 문제를 매주 다시 계산한다.
여기까지는 전통적인 최적화 소프트웨어도 할 수 있다. NVIDIA cuOpt는 수천 개 변수와 제약조건을 섞은 혼합정수선형계획 문제를 풀고, 어느 부품이 실제 병목인지 찾아낸다. 문제는 수학만으로는 현장의 모든 정보를 볼 수 없다는 데 있었다.
공급업체와 주고받은 이메일, 특정 지역의 악천후, 지정학적 사건, 마지막 공급업체 회의의 분위기 같은 정보는 기존 최적화 모델의 변수에 쉽게 들어가지 않는다.
엔비디아와 팔란티어의 백테스트에서는 인간 플래너가 이런 정성 정보를 활용해 수리 모델보다 더 나은 판단을 내리는 경우가 확인됐다. 새 시스템의 핵심은 바로 이 ‘사람의 암묵지’를 데이터로 남기는 데 있다.
팔란티어 Ontology는 데이터베이스가 아니라 ‘회사 운영의 지도’다
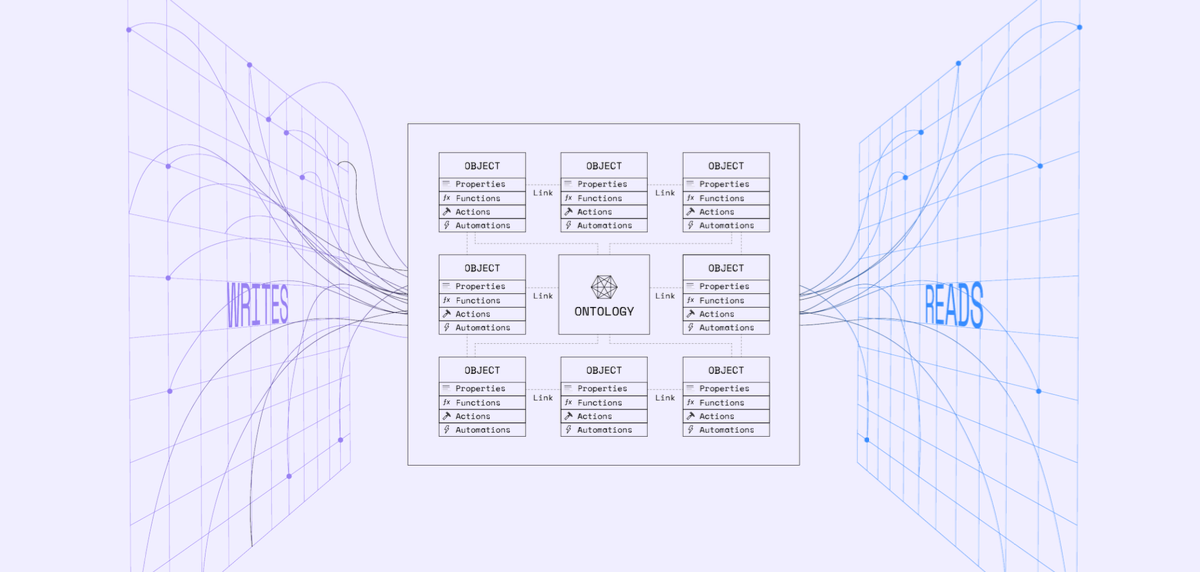
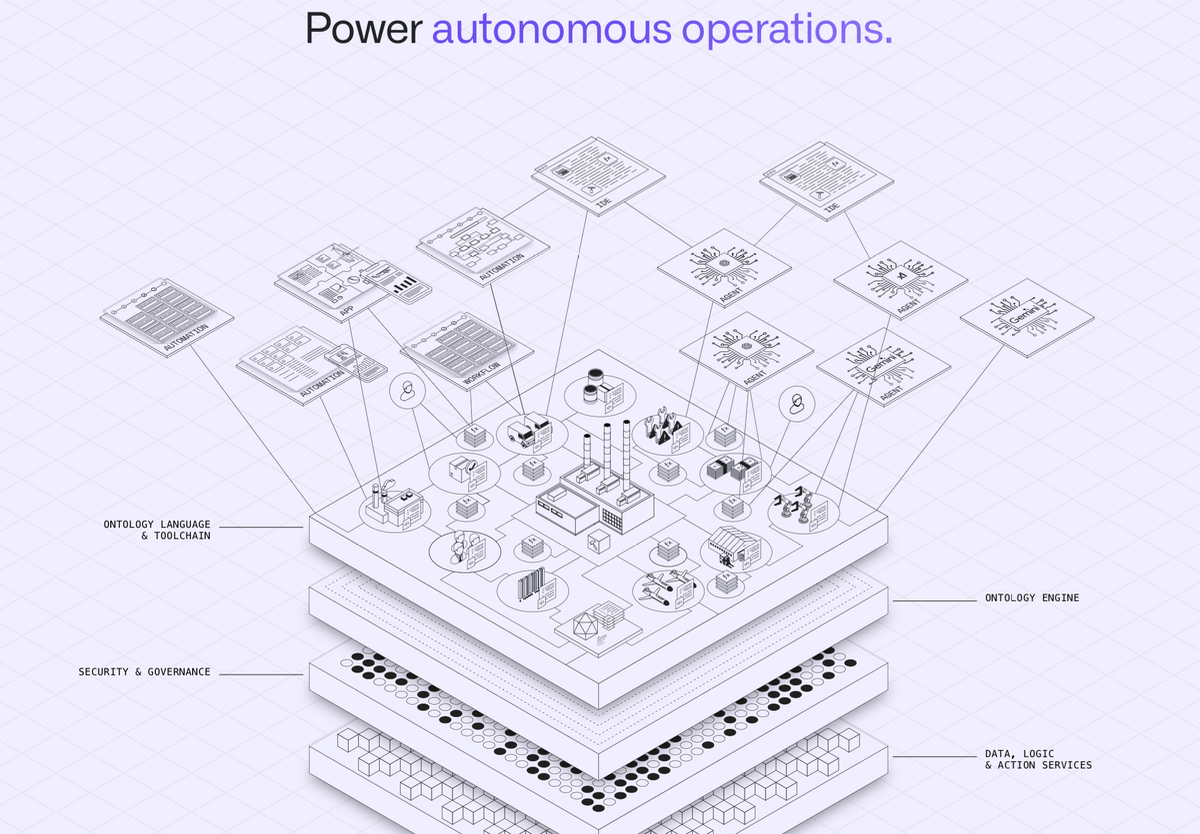
팔란티어 Ontology를 이해하면 이번 협업이 왜 단순한 LLM 도입이 아닌지 보인다. 일반 데이터베이스가 재고, 공장, 주문을 각각의 테이블로 보관한다면 Ontology는 이를 ‘부품 - 공장 - 생산능력 - 고객 약속 - 실제 산출량’처럼 서로 연결된 객체와 관계로 표현한다.
이 구조 위에서 AI는 단순히 문서를 읽는 것이 아니라 “이 부품이 늦어지면 어느 생산라인과 고객 납기가 영향을 받는가”를 운영 맥락 속에서 판단할 수 있다. 엔비디아는 Palantir Foundry 안에 이를 통합한 Digital Supply Chain Intelligence 명령센터를 구축했다.
정량 영역은 cuOpt가 맡고, 정성 영역은 Nemotron이 맡는다. 플래너가 AI의 권고를 승인하거나 수정하거나 거부한 기록과 실제 생산 결과는 다시 Ontology로 돌아간다. 중요한 점은 모델이 현장에서 제멋대로 자기 학습하는 구조가 아니라, 충분한 데이터가 쌓였을 때 별도의 통제된 재학습 절차를 거친다는 것이다.
86.7%의 의미 - 큰 모델보다 ‘회사 일을 배운 작은 모델’이 더 잘했다
가장 흥미로운 숫자는 모델 크기가 아니다. 300억 파라미터 규모의 Nemotron 3.5 Lightning을 엔비디아의 과거 배분 판단과 근거, 결과로 사후 학습하자 내부 개발 벤치마크 정확도가 17.5%에서 86.7%로 올라갔다. 5,500억 파라미터급 Nemotron 3 Ultra의 55.5%도 넘어섰다.
다만 이 숫자를 “작은 모델이 초거대 모델보다 똑똑해졌다”고 읽으면 안 된다. 엔비디아도 이 결과가 경계가 명확한 특정 자재 배분 업무에서 나온 것이라고 명시했다. 생산 리스크 예측처럼 다른 문제는 미세조정 이후에도 어려웠다.
오히려 투자자에게 중요한 교훈은 다른 데 있다. 기업용 AI에서 경쟁력은 가장 큰 모델을 사는 데서 끝나지 않는다. 자사 업무의 의사결정 기록을 얼마나 잘 구조화하고, 그것을 작은 모델에 얼마나 반복적으로 학습시키느냐가 비용과 성능을 동시에 좌우할 수 있다.
이것은 ERP의 종말이 아니라 ‘ERP 위의 판단 계층’ 경쟁이다
이번 발표를 “팔란티어와 엔비디아가 SAP나 Oracle을 대체한다”는 이야기로 확대할 필요는 없다. 실제 공장은 여전히 ERP, MES, MRP 같은 기존 시스템에서 주문과 재고, 생산을 관리한다. 새 AI 스택은 그 위에서 서로 흩어진 데이터를 연결하고, 가능한 선택지를 계산하고, 인간에게 실행 권고를 주는 판단 계층에 가깝다.
| 구분 | 기존 기업 시스템 | 이번 AI 운영 계층 |
|---|---|---|
| 주요 역할 | 거래·재고·생산 기록 | 상황 해석·최적화·권고 |
| 핵심 데이터 | 정형 데이터 중심 | 정형 + 이메일·회의·외부 리스크 |
| 의사결정 | 사람이 시스템을 조회해 판단 | AI가 대안을 만들고 사람이 최종 승인 |
| 학습 | 프로세스 규칙 중심 | 판단·수정·결과를 재학습 데이터로 축적 |
이 관점에서 팔란티어의 가장 중요한 자산은 챗봇이 아니라 Ontology다. 엔비디아의 가장 중요한 역할도 GPU 판매에 그치지 않는다. cuOpt, Nemotron, NeMo 툴체인까지 포함해 기업의 운영 AI 전체를 자사 컴퓨팅 생태계에서 돌리게 만드는 것이다.
이번 협업을 ‘산업 AI 운영체제의 완성’이라고 부르기에는 아직 이르다. 현재 공개된 성과는 엔비디아 내부의 특정 자재 배분 문제를 대상으로 한 개발 벤치마크다. 실제 고객사의 생산성, 재고회전, 리드타임, 현금흐름이 얼마나 개선됐는지는 앞으로 더 확인해야 한다.
그럼에도 이번 사례가 중요한 이유는 엔터프라이즈 AI의 다음 경쟁 지점을 구체적으로 보여줬기 때문이다. 2023 - 2025년의 기업 AI가 “사내 문서를 얼마나 잘 검색하고 요약하느냐”였다면, 다음 단계는 “기업이 실제로 어떤 결정을 내리고, 그 결정이 어떤 결과를 만들었는가”를 학습하는 쪽으로 이동하고 있다.
이 변화가 확산된다면 팔란티어는 데이터 분석 회사보다 기업의 의사결정 메모리와 실행 규칙을 관리하는 플랫폼 으로 평가받을 여지가 커진다. 엔비디아도 GPU 업체를 넘어 그 판단을 학습시키고 실행하는 컴퓨팅 스택의 공급자가 된다.
반대로 이 논리가 약해지는 조건도 분명하다. 고객마다 온톨로지를 구축하는 비용과 시간이 너무 크거나, 실제 ROI가 컨설팅 비용을 넘지 못하거나, 기업이 핵심 운영 판단을 한 공급업체 스택에 종속시키는 것을 꺼린다면 확산 속도는 예상보다 느릴 수 있다. 소프트웨어가 HBM 수율이나 패키징 캐파 같은 물리적 부족 자체를 만들어낼 수도 없다.
- 아직 아니다. 공개된 구조에서는 AI가 권고안과 근거를 제시하고 인간 플래너가 최종 결정을 내린다.
- 엔비디아는 모델이 운영 중 스스로 재학습하지 않는다고 명시했다.
- 아니다. 엔비디아 내부의 특정 자재 배분 의사결정 개발 벤치마크다.
- 다른 업무나 다른 기업에서 같은 수치가 나온다는 보장은 없다.
- 현재 공개된 구조는 ERP·MES를 없애기보다 그 데이터를 연결하고 의사결정을 돕는 상위 운영 계층에 가깝다.
- 기존 기간계 시스템과의 통합 역량이 오히려 확산의 핵심 조건이다.
- GPU 수요뿐 아니라 Nemotron, cuOpt, NeMo 등 엔비디아 소프트웨어가 기업 운영 워크로드에 들어가는 실제 사례라는 점이 중요하다.
- 다만 이것이 당장 별도 대규모 매출원이 됐다는 뜻은 아니다. 상용 확산과 수익화는 추가 확인이 필요하다.
체크 포인트
인사이트 타임스 편집부