AI가 말을 덜 할수록 더 싸진다 - Jev가 보여준 ‘판단 모델’의 투자 함의
TypeSafe AI가 공개한 Jev는 더 잘 쓰는 챗봇이 아니다. 오히려 반대다. 문장을 길게 생성하는 능력을 포기하고, 소프트웨어가 바로 실행할 수 있는 확률, 선택, 점수에 집중한다. 이 접근이 중요한 이유는 AI 산업의 다음 경쟁축이 “누가 가장 똑똑한 모델을 만드느냐”에서 “누가 지능을 가장 싸고 빠르게 소프트웨어 안에 심느냐”로 넓어질 수 있기 때문이다.
20초 핵심
챗봇이 아니라 ‘AI 조건문’
기존 LLM은 무엇을 물어도 결국 문자열을 만든다. JSON을 요청해도 본질은 토큰을 한 개씩 순차 생성하는 방식이다. 애플리케이션은 그 결과를 다시 파싱하고 검증한 뒤 실행해야 한다.
참일 확률
고객 문의가 환불 조건에 해당하는지처럼 yes / no 판단을 확률과 함께 반환한다.
선택지 고르기
영업, 결제, 기술지원 가운데 어느 팀으로 보내야 하는지처럼 미리 정한 답 중 하나를 고른다.
순서가 있는 점수
위험도, 긴급도, 품질처럼 서열이 있는 평가값을 반환한다.
TypeSafe는 여기에 RLCD, Reinforcement Learning for Calibrated Decisions라는 학습 방식을 적용했다고 설명한다. 핵심은 “80% 확신”이라는 숫자가 실제 정답률과 어느 정도 맞아떨어지도록 보정하는 것이다. 이것이 제대로 작동한다면 개발자는 “95% 이상이면 자동 실행, 80~95%는 상위 모델에 재질문, 그 아래는 사람에게 전달” 같은 운영 규칙을 만들 수 있다.
개발자에게 왜 큰 변화인가
개발자가 얻는 가장 큰 이익은 모델 IQ보다 시스템 복잡도 감소다.
LLM 호출 → 텍스트 생성 → JSON 파싱 → 형식 검증 → 재시도 → 후속 호출
입력 → 구조화된 확률 · 선택 · 점수 → 조건문 실행 또는 상위 모델로 escalation
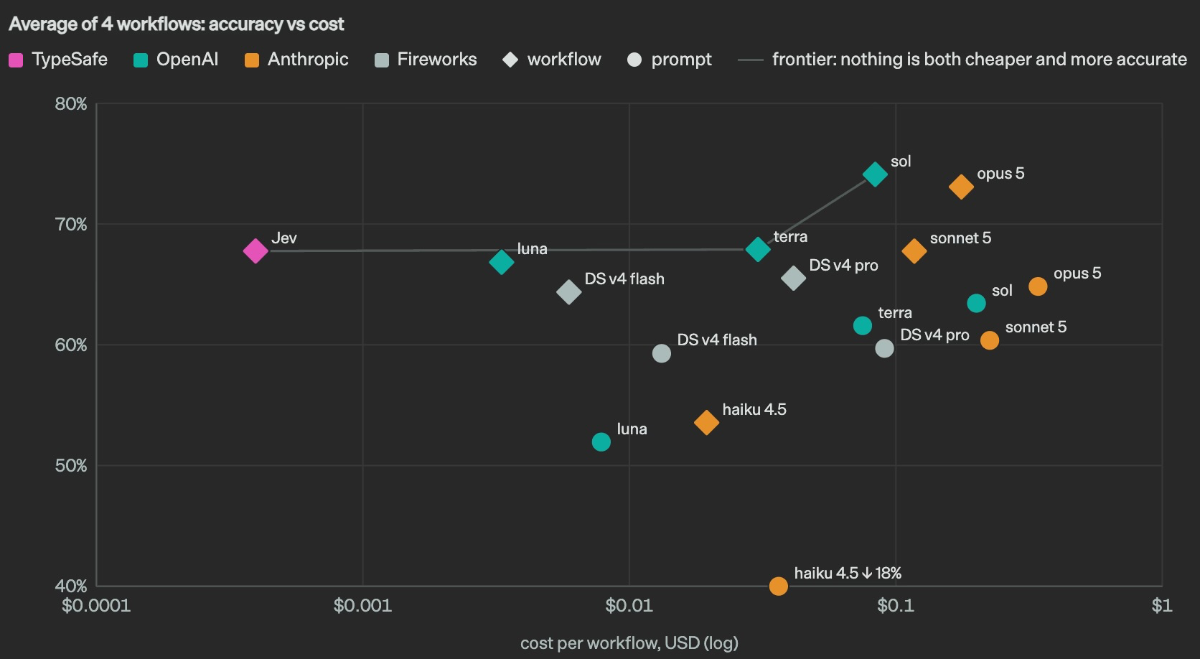
가격도 눈에 띈다. TypeSafe가 공개한 Jev 가격은 입력 10억 토큰당 42달러다. 다시 말해 100만 입력 토큰당 0.042달러다. 원문에 흔히 적히는 “토큰당 0.0424달러”는 단위가 100만 배 잘못된 표현이다. 출력은 현재 별도 과금하지 않는다.
100만 입력 토큰당 공개 가격.
TypeSafe가 설명하는 일반적 end-to-end 범위.
동급 System One 형태 작업에서의 속도 개선 주장.
홈페이지의 특정 워크플로 예시는 193.6배 빠르고 444.6배 저렴하다고 제시한다. 이 숫자를 보편적 성능으로 확대 해석해서는 안 된다. 그러나 방향 자체는 분명하다. 생성하지 않아도 되는 작업에서 생성 비용을 없애자는 것이다.
생산성 향상은 어디서 나오는가
첫째, 실시간 UX. 5초 걸리는 AI는 사용자가 기다려야 하는 기능이지만 0.1~0.5초 AI는 검색, 편집기, 게임, 브라우저, 업무 소프트웨어의 내부 로직이 될 수 있다.
둘째, 에이전트의 단계당 비용. 에이전트는 한 번 답하는 챗봇과 달리 관찰하고, 판단하고, 클릭하고, 다시 확인하는 작업을 수십 번 반복한다. “쉬운 판단은 Jev, 어려운 추론은 프런티어 LLM”으로 라우팅하면 평균 비용을 낮출 여지가 크다.
셋째, 실패를 설계할 수 있다. 확률이 잘 보정돼 있다면 자동화는 ‘맞다/틀리다’의 문제가 아니라 임계치 설계 문제가 된다. 기업 소프트웨어에서 중요한 것은 100% 정확한 모델보다, 불확실할 때 스스로 멈추고 더 비싼 모델이나 사람에게 넘길 수 있는 시스템이다.
투자자가 봐야 할 더 큰 변화 - AI의 ‘분업화’
Jev가 보여주는 진짜 투자 테마는 새로운 모델 하나가 아니다. AI 스택의 분업화다.
앞으로 하나의 애플리케이션 안에서도 창작과 복잡한 추론은 대형 생성 모델, 분류와 라우팅은 판단 모델, 반복 계산은 전통 코드, 위험 검증은 별도의 evaluator가 맡는 구조가 자연스러워질 수 있다. 지금까지 “어떤 LLM을 쓰느냐”가 핵심이었다면 앞으로는 “어떤 작업에 어떤 크기의 지능을 배치하느냐”가 원가 경쟁력이 된다.
이는 AI SaaS 기업에 특히 중요하다. 매출이 늘어도 모델 API 비용이 함께 늘면 소프트웨어의 전통적인 높은 총마진 구조가 약해진다. 반대로 판단 업무를 훨씬 저렴한 모델로 내릴 수 있다면 같은 매출에서도 gross margin과 free cash flow가 개선될 수 있다. AI 애플리케이션 기업의 가치평가에서 ‘모델 호출 비용을 얼마나 효율적으로 관리하는가’가 더 중요한 지표가 될 가능성이 있다.
비용이 내려가는데 GPU 수요는 오히려 늘 수 있다
Jev라는 이름은 경제학자 윌리엄 스탠리 제번스에서 가져왔다. 효율이 좋아져 단위 비용이 내려가면 사용량이 오히려 늘 수 있다는 ‘제번스의 역설’을 AI에 적용한 것이다.
따라서 엔비디아나 클라우드 수요에 곧바로 악재라고 보기는 어렵다. 한 번의 판단에 필요한 연산량은 줄어들 수 있지만, 가격이 10분의 1 또는 100분의 1로 내려가면 소프트웨어가 AI를 호출하는 횟수는 훨씬 더 빠르게 늘어날 수 있다.
투자자가 봐야 할 질문은 “토큰 가격이 내려가면 GPU 수요가 줄어드는가”가 아니다. 더 정확한 질문은 “추론 한 건의 비용 하락보다 AI 호출량 증가가 더 빠른가”다.
누가 득을 보고, 누가 압박받나
| 영역 | 가능한 영향 | 투자자가 볼 것 |
|---|---|---|
| 에이전트 · 브라우저 자동화 | 작은 판단을 반복하므로 지연시간과 호출비 절감 효과가 큼 | 업무당 호출 횟수, 성공률, 상위 모델 재호출 비율 |
| AI SaaS | 모델 원가가 낮아지면 gross margin 개선 가능 | Inference COGS, gross margin, FCF |
| 프런티어 LLM | 단순 판단은 내려놓고 복잡한 생성 · 추론에 집중 가능 | 고부가 작업 비중과 전체 API 사용량 |
| GPU · Cloud | 건당 연산량 감소와 총 호출량 증가가 동시에 발생 가능 | Total inference volume, utilization, CapEx ROI |
| 단순 LLM 래퍼 | 분류 · 라우팅만으로 높은 가격을 받기 어려워질 수 있음 | 제품 차별화, 자동화율, 고객 유지율 |
Jev를 “LLM 이후의 모델”이라기보다 “LLM 아래에 새로 생기는 지능 계층” 으로 보는 편이 더 타당하다고 생각한다.
대형 언어모델은 여전히 창작, 복잡한 추론, 코딩, 긴 맥락 이해에서 필요하다. Jev는 그 시장을 통째로 대체하기보다 대형 모델을 매번 호출할 필요가 없는 수십억 개의 작은 판단을 가져오려는 시도에 가깝다.
이 구조가 자리 잡으면 AI 산업의 핵심 경제식도 달라진다. 모델 성능 × 호출당 비용 × 호출 빈도 × 자동화 성공률. 지금까지 시장은 첫 번째 항목에 집중했다. Jev가 던지는 질문은 나머지 세 항목이 실제 기업가치를 더 크게 좌우할 수 있지 않느냐는 것이다.
다만 아직은 초기다. Jev는 2026년 9월 15일 공개된 early access 제품이고, TypeSafe의 강한 성능 주장은 대부분 자체 워크플로 평가에 기반한다. ‘구조화된 출력이므로 타입 오류가 없다’와 ‘현실 세계의 판단을 틀리지 않는다’는 전혀 다른 말이다.
- 현재 구조로는 대체재보다 보완재에 가깝다. Jev는 긴 문장을 생성하지 않으며 미리 정의된 판단 문제에 강점을 둔다.
- 출력 타입 밖의 임의 문자열을 만들지 않으므로 schema 오류를 막을 수 있다는 뜻에 가깝다. 선택지 안에서 잘못된 판단을 내릴 가능성은 여전히 있다.
- 파싱, schema 검증, 재시도, 일부 guardrail 코드를 줄일 수 있다. 다만 임계치 설정, 모니터링, fallback 설계는 새로 필요하다.
- 단정하기 어렵다. 건당 연산량은 줄 수 있지만 훨씬 싼 AI가 소프트웨어 곳곳에 삽입되면 총 호출량은 더 빠르게 늘 수 있다.
- 아니다. 실제 운영 환경의 자동화 성공률 × escalation rate × 총비용 이 더 중요하다. 자주 틀려 상위 모델에 다시 보내야 한다면 표면 가격만큼 경제성이 좋아지지 않는다.
체크 포인트
인사이트 타임스 편집부