중국은 Nvidia GPU보다 더 어려운 것을 복제하기 시작했다, CUDA다
DeepSeek와 Huawei가 Ascend용 연산, 통신, 프로그래밍 도구를 오픈소스로 풀었다. 중국의 Nvidia 대체전이 이제 칩의 속도만이 아니라 개발자가 얼마나 쉽게 옮겨갈 수 있는지를 겨루는 단계로 들어가고 있다.
20초 핵심
GPU를 만드는 것보다 어려운 일
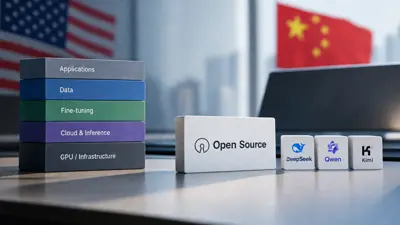
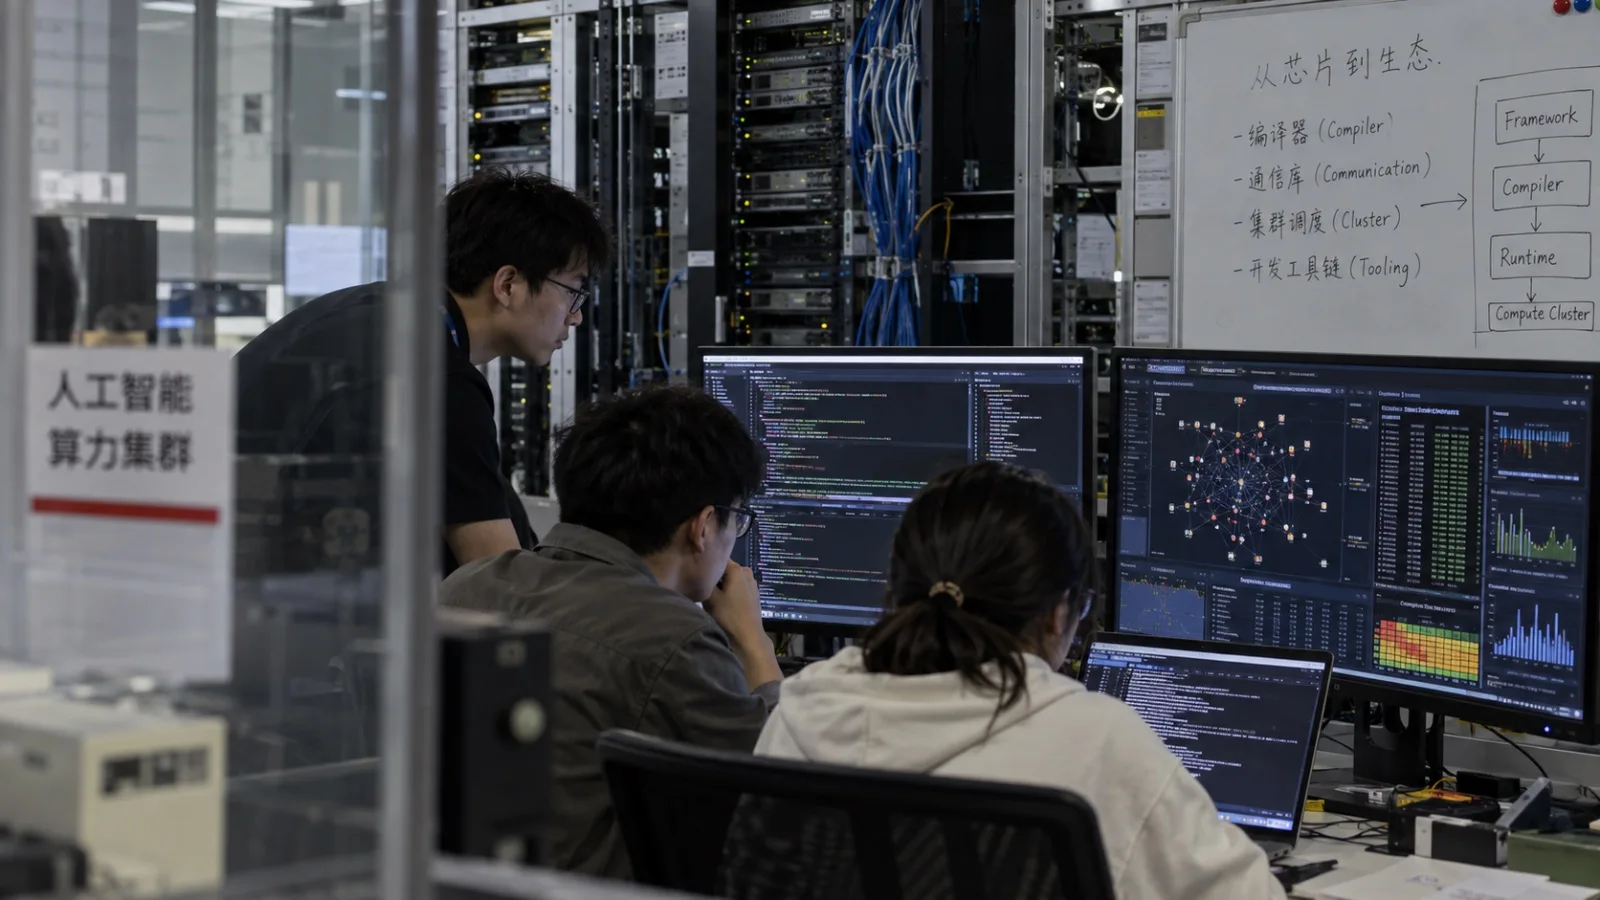
AI 개발자는 GPU의 트랜지스터를 직접 다루지 않는다. 실제 작업은 컴파일러, 라이브러리, 프레임워크, 커널과 통신 소프트웨어를 거친다. Nvidia가 2006년 CUDA를 내놓은 뒤 약 20년 동안 쌓은 경쟁력은 이 전체 개발환경에 있다.
그래서 Nvidia의 해자는 Hardware × Software × Developers로 보는 편이 정확하다. 칩이 빨라도 개발이 어렵고 기존 PyTorch workload를 옮기는 데 많은 엔지니어링 비용이 든다면 총소유비용은 올라간다. 반대로 하드웨어가 다소 불리해도 소프트웨어가 편하고 클러스터 전체 효율이 높다면 실제 구매 판단은 달라질 수 있다.
DeepSeek가 메운 세 개의 빈칸
DeepGEMM-Ascend는 AI의 핵심 행렬연산을 Ascend에서 효율적으로 수행하는 커널 라이브러리다. BF16, FP8, FP4 등을 지원하며 기존 DeepGEMM과 API 호환성을 유지한다. 중요한 것은 개발자가 Ascend의 저수준 하드웨어 복잡성을 덜 의식하면서 기존 개발 흐름을 이어갈 수 있게 한다는 점이다.
DeepEP-Ascend는 더 전략적이다. MoE 모델의 expert parallel 통신 등 여러 NPU가 데이터를 주고받는 작업을 담당한다. 거대한 AI 모델은 칩 하나의 FLOPS가 아니라 수십, 수백, 수천 개 가속기를 얼마나 효율적으로 묶느냐가 성능과 비용을 좌우한다.
TileLang의 Ascend 950 지원은 개발 진입장벽을 낮추는 층이다. Python에 가까운 고수준 문법으로 고성능 커널을 작성하면서 Ascend용 코드 생성, 스케줄링과 동기화를 처리하도록 설계됐다.
연산 효율
칩 간 연결
개발 편의성
중국의 답은 ‘더 좋은 칩’만이 아니다
Huawei의 최근 전략과 연결하면 그림이 선명해진다. 회사는 UnifiedBus를 기반으로 단일 시스템에서 대규모 NPU를 묶고, 장기적으로는 여러 SuperPoD를 연결해 최대 100만 NPU급 클러스터까지 확장하는 로드맵을 제시했다. 이 수치는 Huawei의 계획이며 실제 성능과 경제성이 검증됐다는 뜻은 아니다.
개별 칩의 열세를 인정하지 않는 전략이 아니라, 칩의 약점을 시스템 규모와 소프트웨어로 상쇄하려는 전략에 가깝다.
이 때문에 DeepEP-Ascend 같은 통신 소프트웨어의 가치가 커진다. 가속기를 많이 붙일수록 통신 지연과 대역폭, 메모리 이동이 병목이 된다. 수천 개 칩을 보유해도 유효 연산시간이 낮으면 경제성이 무너진다. AI 반도체 경쟁의 단위가 ‘칩’에서 ‘랙과 클러스터 전체의 유효 처리량’으로 이동하는 이유다.
왜 Huawei 혼자가 아니라 DeepSeek인가
하드웨어 업체가 자체 도구만 만들면 공급자 중심의 폐쇄 생태계가 되기 쉽다. DeepSeek는 실제 대형 모델을 훈련하고 추론하는 사용자의 위치에 있다. DeepGEMM과 DeepEP의 Ascend 버전이 기존 API와 개발 흐름을 최대한 맞추려는 것도 이 점에서 중요하다.
오픈소스는 여기서 유통 전략이다. 외부 개발자가 사용하고, 버그를 찾고, 최적화를 추가하고, 다시 더 많은 개발자가 들어오는 Developer Flywheel을 만들 수 있기 때문이다. 중국이 복제하려는 것은 CUDA 코드 자체라기보다 CUDA가 지난 20년 동안 만든 네트워크 효과에 더 가깝다.
투자자가 봐야 할 것
이번 공개를 “중국판 CUDA 완성”으로 해석하면 너무 빠르다. CUDA는 단일 라이브러리가 아니다. 컴파일러, 수백 개 라이브러리와 SDK, 디버깅과 프로파일링 도구, 프레임워크 최적화, 클라우드 지원, 수백만 개발자의 경험이 겹쳐진 플랫폼이다.
더 현실적인 위험은 CUDA 독점의 경제적 가치가 조금씩 낮아지는 것 이다. 중국 내 AI 기업이 “최고 성능이 아니어도 이전 비용이 충분히 낮고 공급이 안정적이면 Ascend를 쓰겠다”고 판단하기 시작하면 Nvidia가 가진 소프트웨어 프리미엄은 일부 시장에서 약해질 수 있다.
반대로 Ascend 도구가 특정 DeepSeek workload에서만 잘 작동하거나, 대규모 클러스터의 안정성, 디버깅, 프레임워크 호환성이 따라오지 못한다면 CUDA의 해자는 오히려 재확인된다. 지금은 승패를 선언할 시점보다 전환비용이 실제로 내려가는지 측정할 시점 이다.
- 아직 그렇게 부르기 어렵다. 이번 공개는 CUDA 전체의 대체재라기보다 연산 커널, 통신, 고수준 프로그래밍 등 핵심 층을 Ascend에 강화한 것이다. CUDA의 도구와 개발자 기반은 훨씬 넓다.
- 단기 실적을 흔들 사건으로 보기에는 근거가 부족하다. 다만 중국 시장에서 Nvidia 대체 가속기의 사용 장벽이 낮아지는 방향은 장기 경쟁구도에서 확인해야 할 변수다.
- 가능성은 있다. 구매자는 단일 칩 benchmark가 아니라 공급 가능성, 시스템 처리량, 전력, 개발비용과 총소유비용을 함께 본다. 다만 더 많은 칩으로 성능을 보완하면 전력과 네트워크, 운영 복잡성이 커지는 반대 비용도 생긴다.
- 오픈소스 공개가 실제 외부 채택으로 이어지지 않거나, 대규모 클러스터 안정성과 소프트웨어 호환성이 기대에 못 미치는 경우다. 반대로 제3자 workload에서도 이전 비용과 성능 격차가 빠르게 줄면 경쟁 위협은 예상보다 빨리 커질 수 있다.
체크 포인트
인사이트 타임스 편집부