4억달러짜리 기계 한 대가 AI칩의 미래를 결정한다
Nvidia에는 AMD가 있고, TSMC에는 Samsung과 Intel이 있습니다. 그런데 이 경쟁자들이 더 작은 트랜지스터를 만들려면 결국 같은 회사의 장비를 찾습니다. AI 반도체 산업의 가장 아래층에서 ASML의 독점력이 더 강해지는 이유입니다.
20초 핵심
반도체 공장에 5,000억원짜리 기계가 들어온다
반도체 장비 한 대에 4억달러. 숫자만 보면 납득하기 어렵습니다. 웬만한 제조업 공장 하나를 지을 돈으로 기계 한 대를 사는 셈입니다.
그런데 고객들은 실제로 움직이고 있습니다. Reuters에 따르면 기존 EUV 장비는 2027년 생산분이 사실상 대부분 예약됐습니다. High-NA는 Intel이 가장 앞서 도입했고, Samsung과 SK Hynix는 2028년부터 DRAM 생산에 활용할 계획입니다. TSMC는 2030년 도입을 예상하고 있습니다.
High-NA를 어렵게 생각할 필요는 없다
노광장비는 웨이퍼 위에 회로를 그리는 초정밀 사진기라고 생각하면 됩니다. 더 작은 회로를 선명하게 그리려면 더 짧은 파장의 빛과 더 좋은 광학계가 필요합니다.
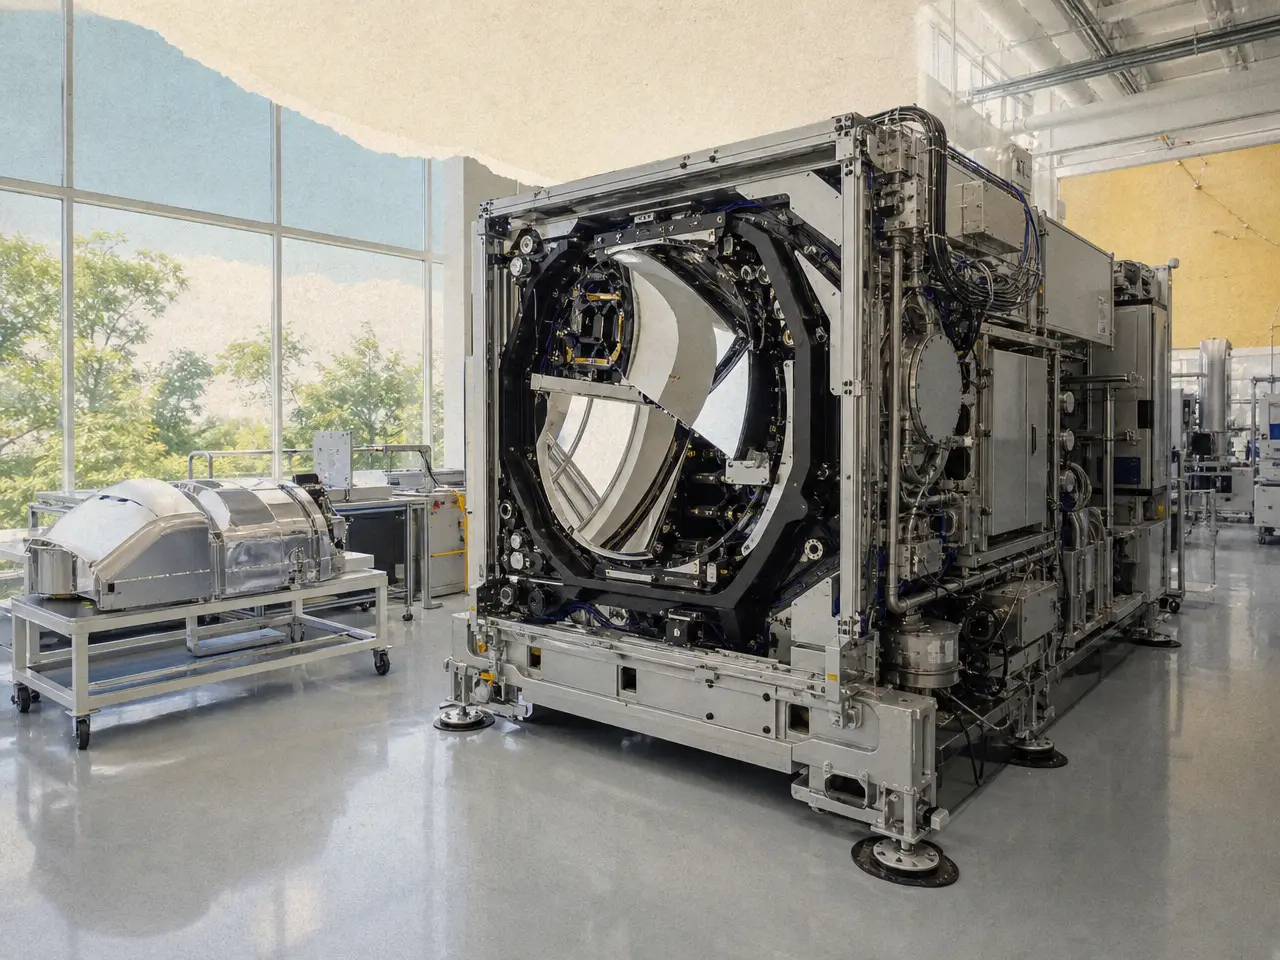
High-NA의 NA는 Numerical Aperture, 즉 빛을 얼마나 넓고 정교하게 모을 수 있는지를 나타내는 값입니다. 기존 EUV의 NA는 0.33, High-NA는 0.55입니다. ASML은 이 변화로 한 번의 노광에서 기존보다 약 1.7배 작은 구조를 만들 수 있다고 설명합니다. 면적으로 보면 구현 가능한 트랜지스터 밀도는 최대 2.9배까지 높아질 수 있습니다.
하지만 진짜 경제성은 선폭보다 공정 횟수에서 나옵니다. ASML은 일부 Logic과 DRAM 공정에서 기존 Low-NA EUV의 3~4회 노광을 High-NA 한 번으로 대체할 수 있다고 밝혔습니다. 특정 핵심 레이어에서는 전체 공정 단계가 10분의 1 수준으로 줄어드는 사례도 확인했습니다.
노광을 여러 번 하면 장비 시간만 늘어나는 것이 아닙니다. 웨이퍼를 옮기고, 코팅하고, 현상하고, 식각하고, 다시 정렬하는 공정이 따라붙습니다. 단계가 늘수록 생산시간과 공장면적이 필요하고 결함이 생길 기회도 많아집니다. High-NA가 충분한 수율과 처리량을 확보한다면 4억달러의 가격표만 보고 경제성을 판단하기 어려운 이유입니다.
AI 반도체 산업을 아래로 내려가면 경쟁자가 사라진다
AI 산업의 위쪽은 경쟁이 치열합니다. 모델은 OpenAI, Google, Anthropic, xAI가 경쟁합니다. 가속기는 Nvidia와 AMD뿐 아니라 Google TPU, Amazon Trainium 같은 자체 칩이 있습니다. HBM은 SK Hynix, Samsung, Micron이 경쟁하고, 첨단 파운드리도 TSMC와 Samsung, Intel이 있습니다.
- AI 서비스와 모델 - 경쟁자 다수
- GPU와 Custom ASIC - Nvidia, AMD, Google, Amazon 등
- HBM - SK Hynix, Samsung, Micron
- Foundry - TSMC, Samsung, Intel
- 첨단 EUV Lithography - 사실상 ASML 한 곳
Reuters에 따르면 ASML은 2025년 전체 노광장비 시장에서 약 94%의 점유율을 차지했고, EUV에서는 상용 경쟁자가 사실상 없습니다. Nikon과 Canon은 다른 노광 분야에서 사업을 하지만 최첨단 EUV를 양산하는 대안은 아직 없습니다.
이 지점에서 ASML의 사업은 전형적인 ‘곡괭이와 삽’보다 한 단계 더 강해집니다. 금을 캐는 회사가 많아질수록 곡괭이 판매자가 유리하듯, AI 가속기 경쟁자가 많아질수록 최첨단 공정을 원하는 고객도 늘어납니다. 누가 GPU 전쟁에서 이기느냐와 별개로 미세화가 계속된다면 ASML은 여러 승자에게 동시에 장비를 팔 수 있습니다.
AI 시대에는 왜 미세화가 더 중요해질까
AI 데이터센터는 성능만 보는 시장이 아닙니다. 같은 전력으로 얼마나 많은 토큰과 연산을 처리하느냐가 서버 경제성을 결정합니다. 칩이 빨라져도 전력소모가 같이 늘면 데이터센터의 전력, 냉각, 랙 수가 따라 증가합니다.
그래서 AI칩에서는 Performance per Watt, 전력당 성능이 특히 중요합니다. 트랜지스터를 더 작게 만들고 같은 면적에 더 많이 넣을 수 있다면 성능과 전력효율을 동시에 개선할 여지가 커집니다.
흥미로운 역설은 Moore’s Law가 쉬워질수록 ASML이 좋아지는 것이 아니라는 점입니다. 오히려 미세화가 어려워질수록 마지막 몇 퍼센트의 성능과 전력효율을 얻기 위해 더 비싼 장비와 더 복잡한 공정이 필요해집니다. 기술 난도가 ASML의 진입장벽으로 바뀌는 구조입니다.
다만 High-NA가 모든 AI칩을 당장 찍는 것은 아니다
여기에는 중요한 반론이 있습니다. 현재 High-NA는 기존 EUV보다 한 번에 노광할 수 있는 면적이 작습니다. Nvidia나 Google이 사용하는 초대형 데이터센터 칩은 다이 크기가 크기 때문에 이 제약이 특히 민감합니다.
ASML은 이를 해결하기 위해 더 큰 마스크 규격을 업계와 공동 개발하고 있습니다. 회사는 2031년 파일럿 라인, 2033년 대량생산 적용을 목표로 하고 있습니다. 따라서 “High-NA가 당장 모든 Nvidia GPU를 만든다”는 식의 해석은 앞서갑니다.
또 4억달러라는 가격은 고객에게도 부담입니다. 기존 Low-NA EUV의 멀티패터닝으로 충분히 경제적인 레이어라면 굳이 High-NA를 쓸 이유가 없습니다. 결국 채택 속도는 장비 가격이 아니라 각 레이어에서의 수율, 처리량, 공정 단계 절감 효과가 결정합니다.
ASML을 Nvidia보다 “더 좋은 회사”라고 단정할 수는 없습니다. 성장률도, 수익구조도, 밸류에이션도 다릅니다. 그러나 해자의 성격은 분명히 다릅니다.
Nvidia의 해자는 CUDA와 시스템 설계, 네트워크, 개발자 생태계에서 나옵니다. 강력하지만 경쟁자는 존재합니다. ASML의 해자는 수십 년 동안 축적된 광학, 광원, 정밀제어, 공급망을 하나의 장비로 통합한 데서 나옵니다. 최첨단 EUV에서는 고객이 선택할 수 있는 대체재가 거의 없습니다.
그래서 ASML 투자에서 더 중요한 질문은 “AI칩 판매가 몇 퍼센트 늘어나는가”보다 “첨단 Logic과 DRAM에서 lithography intensity가 얼마나 높아지는가”입니다. AI 경쟁이 계속되고 각 회사가 더 높은 트랜지스터 밀도와 전력효율을 요구한다면, 경쟁의 결과보다 경쟁 자체가 ASML에 유리할 수 있습니다.
다만 독점 기술이 곧 좋은 투자수익률을 보장하지는 않습니다. 고객의 High-NA 채택 시점, 중국 수출 규제, 장비 생산능력, 그리고 현재 주가에 이미 반영된 성장 기대까지 함께 봐야 합니다.
- 꼭 그렇지는 않습니다. 기존 Low-NA EUV에서도 멀티패터닝을 이용해 더 미세한 구조를 만들 수 있습니다. 문제는 공정 횟수와 비용, 수율입니다. High-NA의 가치는 “불가능을 가능하게 한다”보다 같은 미세화를 더 단순한 공정으로 구현할 가능성에 있습니다.
- 최첨단 EUV 장비의 대체 가능성만 놓고 보면 ASML의 공급자 지위가 더 희소하다고 볼 수 있습니다. 다만 Nvidia는 훨씬 큰 AI 컴퓨팅 매출과 소프트웨어 생태계를 갖고 있어 두 회사를 단순 비교하면 안 됩니다. 해자의 종류가 다릅니다.
- 가능하지만 레이어별로 다릅니다. 여러 번의 노광과 식각, 정렬 공정을 한 번으로 줄이면 장비 시간, 공정 시간, 결함 위험, 팹 공간을 줄일 수 있습니다. 최종 판단은 실제 수율과 처리량을 포함한 웨이퍼당 총비용으로 해야 합니다.
- High-NA 도입이 예상보다 늦어질 가능성, 대형 다이 노광 면적 제약, 고객 CapEx 둔화, 중국 수출 규제, 그리고 높은 밸류에이션입니다. 기술 독점과 주식의 기대수익률은 같은 개념이 아닙니다.
체크 포인트
인사이트 타임스 편집부