Google의 진짜 해자는 검색엔진이 아니라 ‘당신이 무엇을 궁금해했는지’일 수 있다
EU와 Google의 새 법정 싸움은 검색 규제보다 더 큰 질문을 꺼냈다. AI 시대 경쟁우위는 누가 가장 좋은 모델을 만들었는가에서 끝나지 않는다. 그 모델이 어떤 독점적 데이터와 사용자 맥락을 합법적으로 볼 수 있는가가 다음 해자가 될 수 있다.
20초 핵심
EU가 실제로 열라고 한 것은 무엇인가
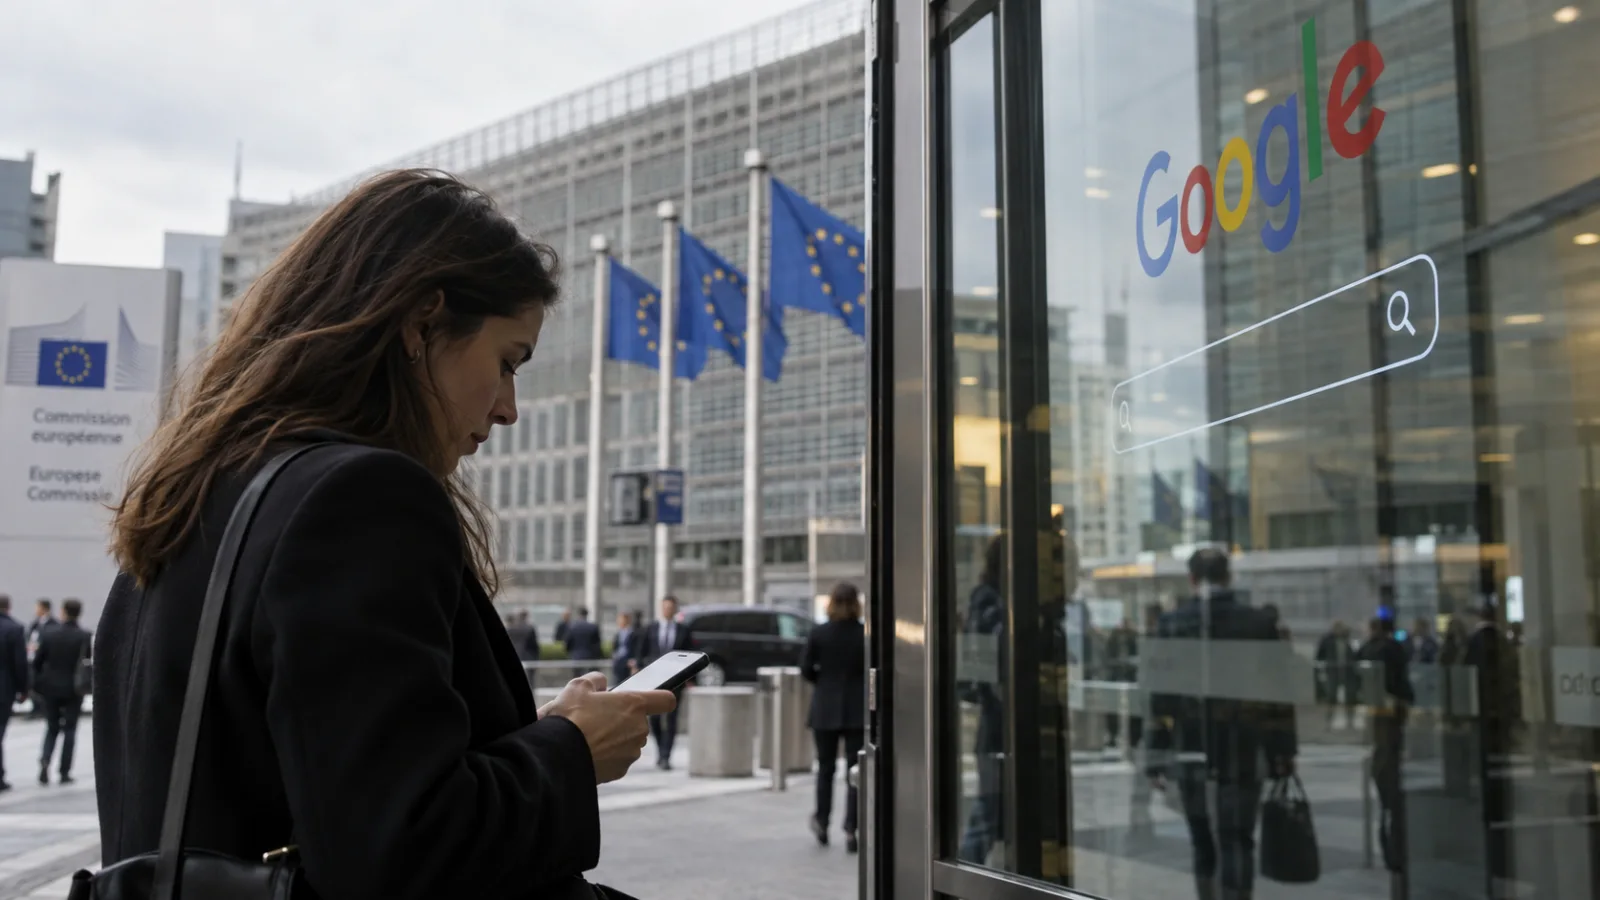
유럽연합 집행위원회는 7월 16일 Digital Markets Act, DMA에 따라 Google에 두 건의 구속력 있는 조치를 내렸다. 첫 번째는 Gemini가 Android에서 쓰는 일부 시스템 기능을 경쟁 AI 서비스도 동등하게 이용할 수 있도록 하라는 것이다. 두 번째는 경쟁 검색엔진과 검색 기능을 제공하는 AI 챗봇에 Google Search의 일부 데이터를 제공하라는 것이다.
여기서 가장 중요한 구분이 있다. EU는 Google 계정정보나 개인별 검색 이력 전체를 공유하라고 요구하지 않는다. 대상은 Google이 검색 품질 개선에 사용하는 query, ranking, click, view 데이터의 일부이며, 긴 검색어와 희귀 단어를 제거하고 위치를 일반화하며 정확한 시간정보를 없애는 등 다층 익명화를 거치도록 했다.
Google의 반론은 ‘익명화라고 해서 충분히 안전하다는 보장은 없다’는 쪽이다. Google은 개인의 민감한 검색이 충분한 익명화 없이 제3자에게 노출될 수 있다고 주장한다. EU는 계정정보와 검색 이력은 공유되지 않고, 사이버보안과 데이터보호 위험이 큰 제3자에 대해서는 Google이 공유 전 위험을 평가할 수 있다고 맞선다.
따라서 지금 단계의 정확한 표현은 이렇다. Google이 검색기록을 OpenAI에 넘기고 있는 것이 아니다. EU가 데이터와 Android 기능의 개방을 명령했고, Google이 그 범위와 안전장치를 법원에서 다투기 시작했다.
검색 데이터가 특별한 이유는 ‘관심’보다 ‘의도’에 가깝기 때문이다
AI 경쟁을 이야기할 때 시장은 주로 Compute와 Model을 봤다. GPU가 얼마나 많은가. 어느 모델이 벤치마크에서 더 높은 점수를 받는가. 하지만 모델의 성능 격차가 빠르게 좁아지는 시장에서는 세 번째 요소인 독점적 데이터의 가치가 커질 수 있다.
Google Search가 축적해 온 신호는 단순한 콘텐츠 소비 기록과 성격이 다르다. YouTube 시청 기록은 관심사를 보여주고, 지도 이용은 장소와 이동 맥락을 보여준다. 반면 검색창에 ‘샌프란시스코 호텔’, ‘Tesla Model Y 가격’, ‘NVDA earnings’를 입력하는 행동은 사용자가 지금 무엇을 해결하려는지에 더 가깝다.
그 경제적 가치는 이미 광고에서 검증됐다. Alphabet의 2025년 4분기 Google Search & Other 광고 매출은 631억달러로 전년동기 대비 17% 증가했다. 같은 분기 Alphabet 전체 매출 1,138억달러의 절반을 넘는다. Search가 여전히 Alphabet 현금창출 엔진의 중심이라는 뜻이다.
AI Agent가 등장하면 데이터의 값은 ‘광고 타기팅’에서 ‘행동 실행’으로 넓어진다
검색 시대의 흐름은 대체로 Intent → Search → Click이었다. 사용자가 의도를 표현하고, 검색결과를 보고, 광고나 웹사이트를 클릭했다.
Agent 시대에는 Intent → AI → Action으로 짧아질 수 있다. Google은 이미 이 방향으로 움직이고 있다. 2026년 공개한 Personal Intelligence는 이용자가 선택하면 Gmail, Photos, YouTube, Search 같은 Google 앱의 맥락을 Gemini와 AI Mode에 연결한다. 여행에서는 과거 예약과 선호를 바탕으로 일정을 만들고, Gemini는 Maps, Flights, Hotels의 실시간 정보와 결합해 추천을 개인화한다.
이 차이는 중요하다. 모델이 세상의 정보를 아는 것과 ‘이 사용자가 무엇을 원하는지’를 아는 것은 다른 능력이다. 전자는 공개 데이터와 대규모 학습으로 어느 정도 따라잡을 수 있다. 후자는 장기간의 사용자 관계, 서비스 접점, 동의 기반의 개인 맥락 연결이 필요하다.
Google의 잠재적 해자는 Gemini 자체만이 아니라 Gemini가 Search, Gmail, Maps, YouTube, Chrome과 연결될 때 생기는 조합에 있을 수 있다.
그래서 DMA의 핵심은 벌금보다 Data Layer다
이번 사건을 수십억달러 벌금 가능성으로만 보면 구조적 의미를 놓친다. 벌금은 일회성 비용일 수 있지만, 경쟁자가 Google이 오랫동안 축적해 온 검색 신호의 일부에 지속적으로 접근할 수 있게 된다면 경쟁조건 자체가 달라진다.
EU의 논리는 명확하다. Google Search는 유럽에서 오랜 기간 90%가 넘는 점유율을 유지해 왔고, 대규모 사용자 데이터가 검색 품질을 개선하며 다시 이용자를 끌어오는 순환을 만든다. 이 데이터가 진입장벽이라면 일정 부분을 익명화해 경쟁자에게 열어야 한다는 것이다.
Google의 논리도 단순한 독점 방어로만 치부하기 어렵다. 검색어에는 건강, 금융, 정치적 관심, 기업 내부정보처럼 민감한 내용이 섞일 수 있다. 익명화 설계가 잘못되면 경쟁 촉진보다 프라이버시 비용이 커질 수 있다.
결국 법원의 쟁점은 ‘데이터를 열 것인가 말 것인가’보다, 어떤 데이터까지 경쟁에 필수적인 자산으로 볼지, 그리고 어느 수준의 익명화와 통제가 있어야 개방이 정당화되는지에 가까워질 가능성이 높다.
Alphabet을 AI 기업으로 평가할 때 Gemini 벤치마크 순위만 보는 것은 부족하다. 모델 순위는 몇 달 사이 바뀔 수 있지만, Search의 의도, YouTube의 관심, Maps의 장소, Gmail의 커뮤니케이션, Chrome의 브라우징 접점이 연결되는 생태계는 훨씬 느리게 움직인다.
다만 이 데이터가 곧바로 하나의 거대한 사용자 프로필로 자유롭게 결합된다고 가정해서도 안 된다. 실제 활용에는 사용자 동의, 제품별 권한, GDPR과 DMA, 보안 설계가 제약으로 작동한다. Google도 Personal Intelligence를 opt-in 방식으로 제공하고 있다.
그래서 이 사안의 투자 포인트는 ‘Google이 데이터를 많이 갖고 있다’가 아니다. 핵심은 Google이 그 데이터를 경쟁사가 쉽게 복제할 수 없는 방식으로 AI 제품의 개인화와 행동 실행에 연결할 수 있는가, 그리고 규제당국이 그 연결의 일부를 어디까지 개방하게 만들 것인가다.
- 아니다. 현재는 EU의 개방 명령을 Google이 법원에서 다투는 단계다. EU가 요구하는 대상도 계정별 검색 이력 전체가 아니라 익명화된 query, ranking, click, view 데이터의 일부다.
- 아니다. EU는 알고리즘이나 검색 기술 자체를 공유하도록 요구하지 않는다고 명시했다. 경쟁자가 자체 검색기술을 개선할 수 있도록 일부 검색 데이터를 제공하라는 조치다.
- 아직 그렇게 단정하기 어렵다. 공유되는 데이터는 Google이 보유한 전체 데이터의 일부이고 익명화와 제한을 거친다. 실제 경쟁효과는 데이터 범위, 최신성, 가격, 이용 자격에 달려 있다.
- 데이터만으로는 부족하다. 모델 품질, 컴퓨팅, 제품 배포력, 사용자 신뢰, 에이전트 실행능력이 함께 필요하다. 다만 모델 성능이 평준화될수록 독점적이고 합법적으로 활용 가능한 데이터의 상대적 가치가 커질 가능성은 있다.
- 모델 성능 차이가 다시 크게 벌어지거나, 개인화가 사용자 만족과 매출로 이어지지 않거나, 규제가 Google의 데이터 결합과 활용을 크게 제한하면 데이터 해자의 경제적 가치는 예상보다 작을 수 있다.
체크 포인트
인사이트 타임스 편집부